谷歌正式发布 Gemini Omni 1.1 Flash,带来一批面向开发者与创意生产的生成式视频能力升级。新版模型现已通过 Gemini API 在 Google AI Studio 开放,将工作室级别的视频创作能力交到开发者手中,用于搭建视频工作流、创意工具、媒体编辑类应用。
- 官方介绍:https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash
本次更新最大的变化,就是大幅提升了生成视频过程当中的可控度与叙事连贯性。
核心新增视频能力
场景扩展,续写更长的视频故事
场景扩展功能可以从一段现有视频的结尾,无缝接续生成后续镜头。
旧版本仅能参考最后 1 秒画面,而 Omni 1.1 Flash 最多能够读取10 秒历史上下文,画面风格、角色、环境的一致性显著提升。每次可向后续写 10 秒,视频累计最长能够生成 40 秒,适合打造连续叙事镜头或是衍生出新的故事支线。
首尾帧指定插值,顺滑运镜过渡
你可以自定义一段视频的起始帧与结束帧,模型会在两张关键帧之间自动生成流畅连贯的动态画面。
这项能力非常适合制作镜头推拉摇移、场景无缝转场、循环动画片段,开发者得以精准控制镜头运动轨迹。
360p草稿模式,快速迭代原型
支持先生成 360p 低分辨率预览视频。对比默认的720p画质,渲染速度提升60%,成本仅为原来三分之一。
快速产出故事板小样,反复调整创意方向,等到效果满意之后,再输出高清成品。
最高4K高清放大输出
预览定稿后,可以渲染输出 1080p 或是 4K分辨率 的成品视频,画质达到专业生产交付标准。
视频参考输入,守住角色画面一致性
创作时能够上传最长 3 秒的参考视频片段。模型以此作为视觉基准,后续生成的镜头就能更好保留人物样貌、服饰、场景风格,减少角色漂移穿帮问题。
上线渠道与可用人群
Gemini Omni 1.1 Flash 正逐步开放上线:
- 开发者:可前往 Google AI Studio 直接测试,也能够在 Gemini Enterprise Agent Platform 完成企业级部署,查阅官方文档接入场景扩展、视频参考、高清放大等接口。
- 订阅用户:Google Flow 面向全球 AI Plus、Pro、Ultra 用户开放 Omni 1.1;场景扩展功能也已经在 Gemini App 上线,供上述订阅者体验。
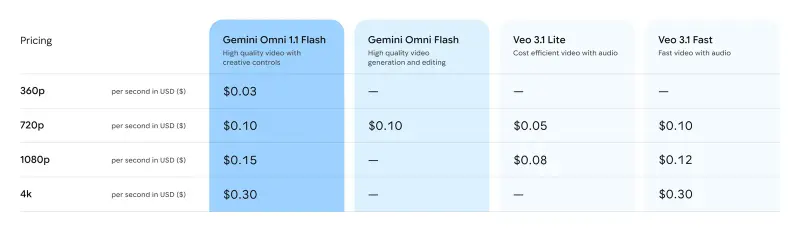
从快速草稿迭代、长镜头续写,到精准运镜插值、高清成品输出,谷歌这套更新,正在一步步补齐生成式视频从原型走向商用落地所需要的各项能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。