腾讯混元团队今日正式发布了新一代语音识别模型 Hy ASR 3.0 preview。与以往仅关注声学特征匹配的 ASR 模型不同,Hy ASR 3.0 基于最新一代大语言模型 Hy3 构建,深度融合了高精度语音识别与深度语义理解能力。
- 腾讯混元:https://aistudio.tencent.com/visual
- 腾讯云:https://cloud.tencent.com/document/product/1093/135476
这一升级标志着语音识别技术正从传统的“逐字转写、单点优化”向“理解语境、兼容场景、一键直出”演进。在更复杂的真实输入中,它不仅能听清声音,更能读懂意图。
核心突破:四大能力全面提升
1. 极低的词错误率(WER)
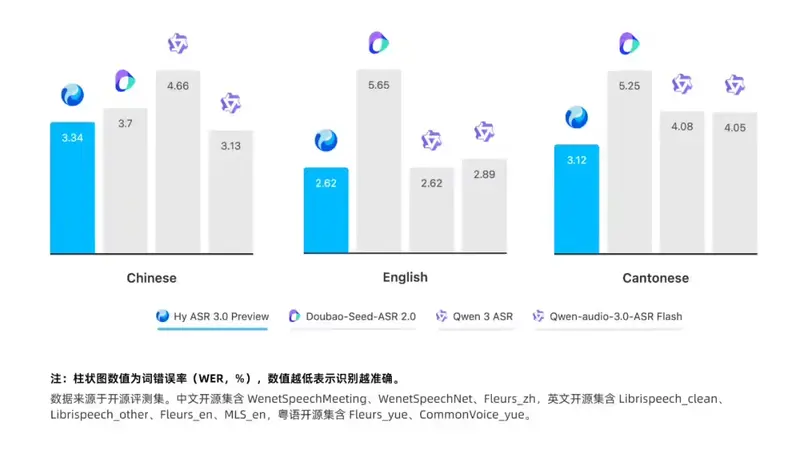
在多个开源及自建评测集上,Hy ASR 3.0 preview 均表现出领先水准:
- 中文普通话:WER 低至 3.34%
- 英语:WER 低至 2.62%
- 粤语:WER 低至 3.12%
即使在多语种混合、长音频识别等复杂场景下,也能有效减少错字、漏字和偏差。
2. 深度上下文感知与智能纠错
依托 Hy3 强大的语言理解能力,模型能够结合 Context 上下文对用户语境进行建模。
- 同音词纠错:自动识别并修正因发音相似但语义不通的错误。
- 意图连贯性:在长对话或多轮交互中,保持语义的逻辑连贯,降低因上下文缺失导致的误判。
3. 复杂声学环境的鲁棒性
针对真实世界中的噪音干扰,Hy ASR 3.0 进行了专项优化:
- 高噪环境:在嘈杂背景音中依然保持稳定的转写效果。
- 非正常发声:对耳语、低声说话等低信噪比场景具备更强的捕捉能力。
4. 方言覆盖与热词注入
- 多方言支持:除了普通话和粤语,还广泛覆盖其他主要方言及口音。
- 行业术语增强:支持热词注入,可快速识别品牌名、产品名、人名及行业专有名词,大幅降低企业在模型适配和词库维护上的成本。
技术架构:MoE + 联合训练
Hy ASR 3.0 preview 的技术底座体现了“效率”与“性能”的平衡:
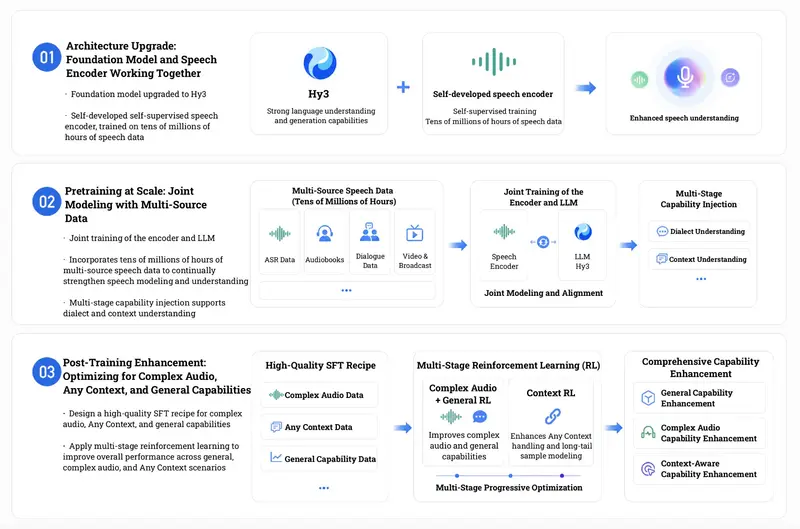
- MoE 架构:采用混合专家(Mixture of Experts)架构,在保证高性能的同时提升推理效率。
- Hy3 基座升级:将基座模型升级为 Hy3,显著增强了语言理解、上下文建模和语义推理能力。
- 无监督语音 Encoder:采用腾讯自研的无监督语音编码器,通过数千万小时的无监督语音数据训练,从复杂音频中提取高质量声学特征。
- 端到端联合训练:语音 Encoder 与大语言模型进行联合训练,引入多来源、多方言、多声学环境的精细化标注数据,实现了声学特征与语义理解的深度对齐。
落地应用:元宝首发,腾讯云 API 开放
目前,Hy ASR 3.0 preview 已在腾讯旗下多款产品中落地:
- 腾讯元宝:已完成首发上线,用户按住说话即可体验方言识别、上下文纠错及复杂环境转写能力的提升,且免费开放。
- WorkBuddy 等办公产品:正在陆续接入中,旨在提升会议记录、语音指令等场景的效率。
- 腾讯云 API:已正式上线,面向智能客服、内容理解、语音搜索等 B 端场景提供技术服务。
© 版权声明
文章版权归作者所有,未经允许请勿转载。