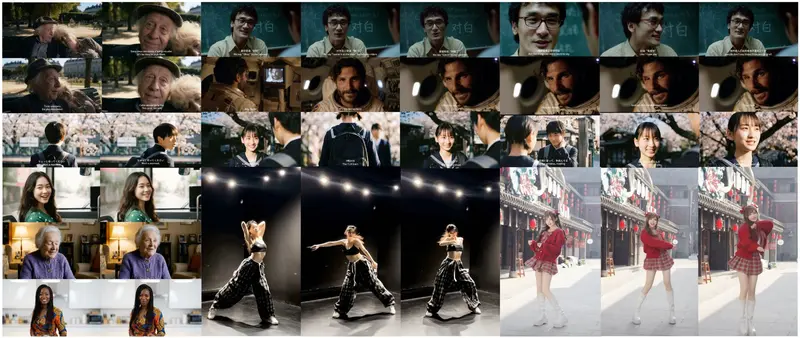
想要在本地全量运行MiniMax H3,至少需要RTX 5090(英伟达Blackwell 架构)显卡,ComfyUI Sol-Attn 是一款专为 SM120 架构设计的稀疏注意力加速插件,旨在解决 MiniMax H3 视频生成模型在处理长序列时的性能瓶颈。
- GitHub:https://github.com/KingGore/ComfyUI_sol-attn_Blackwell
- kijai的方案:https://github.com/kijai/ComfyUI-SolAttn_triton
该插件通过 PyTorch 的 flex_attention 机制执行 Sol-Attn 的稀疏路由,将计算降级为类似 FlashAttention-3 的高效内核。实测数据显示,在长序列(>8k tokens)下,其速度比标准 SDPA(Scaled Dot-Product Attention)快 3.9 倍至 9 倍,且完全避免了串行循环导致的 OOM(显存溢出)问题。
核心性能:越长的序列,加速越明显
Sol-Attn 的核心优势在于其对长上下文的处理能力。随着序列长度增加,标准注意力的计算开销呈二次方增长,而 Sol-Attn 通过稀疏化显著降低了这一负担。
| 序列长度 | 标准 SDPA 耗时 | Sol-Attn 耗时 | 加速比 | 稀疏密度 |
|---|---|---|---|---|
| 4,096 | 2.35 ms | 1.61 ms | 1.46x | 0.15 |
| 8,192 | 9.24 ms | 2.35 ms | 3.93x | 0.11 |
| 16,384 | 36.47 ms | 5.28 ms | 6.91x | 0.09 |
| 32,768 | 144.5 ms | 16.06 ms | 9.00x | 0.08 |
注:测试环境为 MiniMax H3 (H=56, bfloat16, BTHD),预热后数据。
技术亮点:纯 Python 实现,零编译依赖
- SM120 原生优化:利用
torch.compile和flex_attention,在 RTX 5090 上实现无串行循环、无 OOM 的高效计算。 - 自动降级机制:如果检测到不支持的硬件或配置,插件会自动回退到 Triton 参考内核或标准 SDPA,确保生成过程永不中断。
- 跨平台兼容:代码与操作系统无关,支持 Windows、Linux 和 macOS。无需安装 CUTLASS 或 CuTe DSL 等复杂依赖,仅需 PyTorch ≥ 2.6。
- 智能路由:以 128 token 为粒度计算 KV 块的重要性,仅对关键块执行精确注意力计算,从而在保证精度的前提下大幅提升速度。
安装与使用
1. 安装
将插件克隆或下载到 ComfyUI 的 custom_nodes 目录:
cd ComfyUI/custom_nodes/
git clone https://github.com/KingGore/ComfyUI_sol-attn_Blackwell.git
重启 ComfyUI。启动日志中若出现 [Sol-Attn] ✓ GPU: NVIDIA GeForce RTX 5090 (SM120) 即表示安装成功。
2. 工作流集成
在你的 MiniMax H3 工作流中,插入 Sol-Attn MiniMax H3 Patcher 🚀 节点:
[Load Diffusion Model] → [Sol-Attn MiniMaxH3 Patcher] → [KSampler / Sampler Node]
3. 参数说明
- enabled: 启用/禁用加速。
- tau (稀疏温度): 默认 1.0。值越大,跳过的 KV 块越多,速度越快但精度略降。推荐范围 0.8–1.5。
- thresh_type: 阈值估计方式。
diag更快,exact更精确。
兼容性与限制
- 必需硬件:NVIDIA RTX 5090 (SM120) 或其他 Blackwell 消费级 GPU。
- 其他 GPU:在 H100 (SM90)、RTX 40/30 系列等显卡上,插件仍可正常运行,但会自动降级为标准 SDPA,无加速效果。
- 模型限制:目前仅拦截 MiniMax H3 的自注意力层(需满足
skip_reshape=True,head_dim=128,bfloat16)。交叉注意力及其他数据类型不受影响。 - 首次延迟:首次生成时会有约 3-4 秒的
torch.compile预热延迟,后续生成将保持高速。
© 版权声明
文章版权归作者所有,未经允许请勿转载。