MetaView 是由南洋理工大学、快手科技及香港科技大学(广州)联合提出的一种新型单目新视角合成(Novel View Synthesis, NVS)框架。它旨在解决当前生成式模型在空间结构连贯性上的缺失,以及传统显式几何方法在大视角变化下泛化能力不足的问题。
- 项目主页:https://prototypenx.github.io/MetaView/
- GitHub:https://github.com/KlingAIResearch/MetaView
- 模型:https://huggingface.co/Kwai-Kolors/MetaView
- Demo:https://huggingface.co/spaces/hugging-apps/metaview-lightning
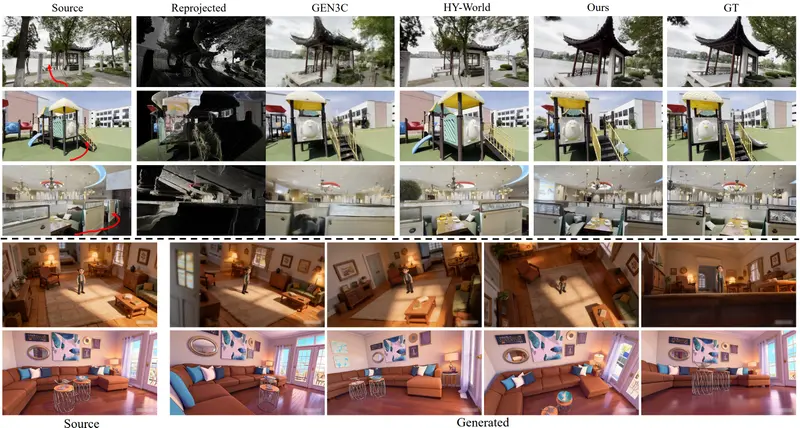
通过巧妙融合隐式几何建模与最小化的显式 3D 线索,MetaView 能够在仅输入单张图像的情况下,实现大视角变化下的高保真、几何一致且尺度可控的新视角渲染。
核心痛点与解决方案
当前的新视角合成技术主要面临两难困境:
- 显式几何方法(如 NeRF/3DGS):虽然空间一致性好,但依赖严格的重建流程,限制了在大视角或复杂场景下的泛化能力。
- 纯隐式生成方法(如扩散模型):灵活性强,但容易产生“尺度漂移”,缺乏精确的相机控制和几何一致性。
MetaView 的创新在于“中庸之道”: 它不强制进行完整的 3D 重建,而是引入“最小但必要”的显式线索来规整隐式生成过程。
关键技术突破
1. 📐 尺度感知隐式几何先验 (Scale-Aware Implicit Geometric Priors)
- 前馈几何感知:利用强大的前馈网络(如 Depth Anything 3)提取输入图像的隐式几何特征。
- 非侵入式融合:这些几何信号并非作为硬性约束,而是通过**并行注意力层(Parallel Attention Layers)**被整合到预训练的 MM-DiT(Multi-Modal Diffusion Transformer)主干网络中。这种方式既规整了生成的结构,又保留了扩散模型的生成灵活性。
2. 📏 通过改进的 RoPE 实现度量尺度锚定 (Metric Scale Anchoring via PRoPE)
- 解决尺度漂移:针对纯隐式方法常见的尺度不一致问题,MetaView 为 Z 轴分配了一个额外的子空间。
- PRoPE (Pose-RoPE):通过改进的位置编码技术,将**度量深度(Metric Depth)**信息显式注入模型,并与相机姿态协同作用。这确保了生成的场景被锚定在一个一致的 3D 度量空间中,从而实现了精确的相机可控性。
性能表现
大量实验表明,MetaView 在以下方面显著优于现有最先进方法(SOTA):
- 大视角变化下的稳定性:即使在输入图像与新视角差异巨大的情况下,仍能保持物体结构的完整性,避免扭曲或伪影。
- 几何一致性:生成的多视角图像在三维空间逻辑上高度自洽。
- 跨领域泛化能力:无需针对特定数据集进行微调,即可在不同风格和数据分布的场景中表现出色。
- 精确相机控制:用户指定的相机轨迹能被准确执行,无明显的尺度漂移或视角偏差。
应用前景
MetaView 的技术特性使其在多个领域具有广泛的应用潜力:
- 虚拟现实 (VR) / 增强现实 (AR):从单张照片快速构建可探索的 3D 环境。
- 电影与游戏制作:辅助镜头调度,从有限素材中生成多角度画面。
- 电商展示:允许用户从任意角度查看商品细节,提升购物体验。
- 数字孪生:低成本地实现物理世界的数字化重现。
© 版权声明
文章版权归作者所有,未经允许请勿转载。