在中国 AI 大模型竞相出海的浪潮中,MiniMax 凭借其在文本、编程及视频多模态领域的深耕,以及对企业友好的开源策略,逐渐建立起独特的技术壁垒。
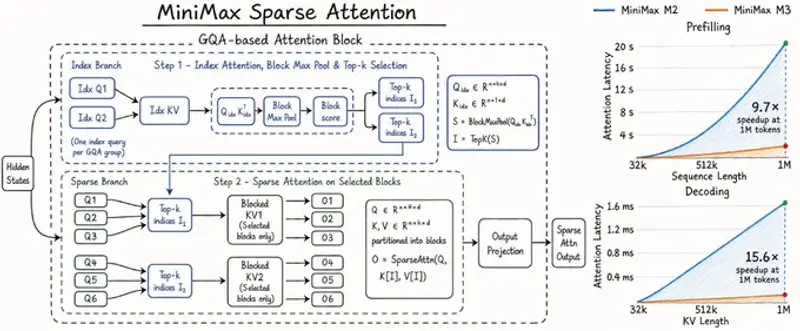
近日,MiniMax 发布了关于其 M2 系列模型的深度技术报告,并正式预告了即将推出的 MiniMax M3 系列。其中,M3 所采用的全新 MiniMax 稀疏注意力(MSA) 机制,有望彻底解决长上下文推理的效率难题。
M3 核心突破:MiniMax 稀疏注意力(MSA)
面对长上下文处理中“二次方缩放”带来的计算爆炸,MiniMax 在 M3 中引入了革命性的 MSA 机制:
- 🚀 极速解码:在 100 万 Token 的序列长度下,预填充延迟提速 9.7 倍,解码阶段提速高达 15.6 倍。
- 🎯 无损精度:不同于 DeepSeek 的 MLA(压缩潜在空间),MSA 在标准 GQA 主干上运行,对真实的、未压缩的 KV 对进行块级动态选择。这既避免了线性/窗口注意力导致的“多跳推理”能力下降,又解决了前缀缓存兼容性问题。
- 💡 经济可行:大幅降低超长上下文 AI Agent 的部署成本,使处理海量文档成为常态而非奢侈。
M2 系列回顾:工程优化的典范
M2 系列(M2, M2.5, M2.7)作为 M3 的前奏,展示了 MiniMax 在工程层面的深厚积累:
1. 🏗️ 高效 MoE 架构
- 参数规模:总参数 2299 亿,每 Token 仅激活 98 亿。
- Sigmoid 门控:引入可学习的专家特定偏置项,减少对辅助损失的依赖,优化路由均衡。
- 全多头注意力(GQA):在全部 62 层中严格使用 GQA,确保在复杂推理任务中的上下文完整性。
2. 🤖 “交错思考”与自我进化
- 思维链持久化:M2 采用“交错思考”协议,将完整的思考历史附加到上下文中,防止状态漂移,提升错误恢复能力。
- M2.7 自主编码:在自动化框架下,M2.7 能分析自身训练日志、诊断异常并修改代码库,承担了 30%-50% 的开发工作流。
- MLE Bench 表现:在独立 24 小时试验中,M2.7 获奖率达 66.6%,媲美 Gemini 3.1 Pro。
3. 🛠️ Forge 训练系统
为支撑长时程 Agent 训练,MiniMax 构建了 Forge 强化学习系统:
- 窗口 FIFO 调度:高吞吐量获取已完成任务,防止集群空闲,保持分布稳定。
- 前缀树合并:将批量训练重组为树计算,共享前缀只计算一次,实现 40 倍 训练加速且近似零误差。
技术抉择:为何放弃“次二次方”捷径?
在 M2 研发期间,MiniMax 曾广泛测试滑动窗口注意力(SWA)和线性注意力等“次二次方”方案,但最终发现:
- 推理缺陷:在超过 32K 上下文时,SWA 在 RULER 128K 任务中分数从 90.0 跌至 72.0,严重损害多跳推理能力。
- 工程障碍:缺乏原生前缀缓存支持,难以与推测解码(MTP)模块对齐。
因此,MiniMax 选择在 M2 中承受全注意力的计算成本以保精度,而在 M3 中通过 MSA 这一更聪明的架构设计,最终实现了速度与精度的双重胜利。
© 版权声明
文章版权归作者所有,未经允许请勿转载。