以前,我们总是评测 AI 模型够不够聪明。
现在,Anthropic 打算反过来:评测你够不够会用 AI。
据最新发现,Anthropic 正在 Claude 应用中测试一项名为 “AI 素养计分卡”(AI Literacy Scorecard) 的新功能。它不再仅仅关注模型输出的质量,而是直接扫描你的对话历史,给你的“提示词工程”能力打分。
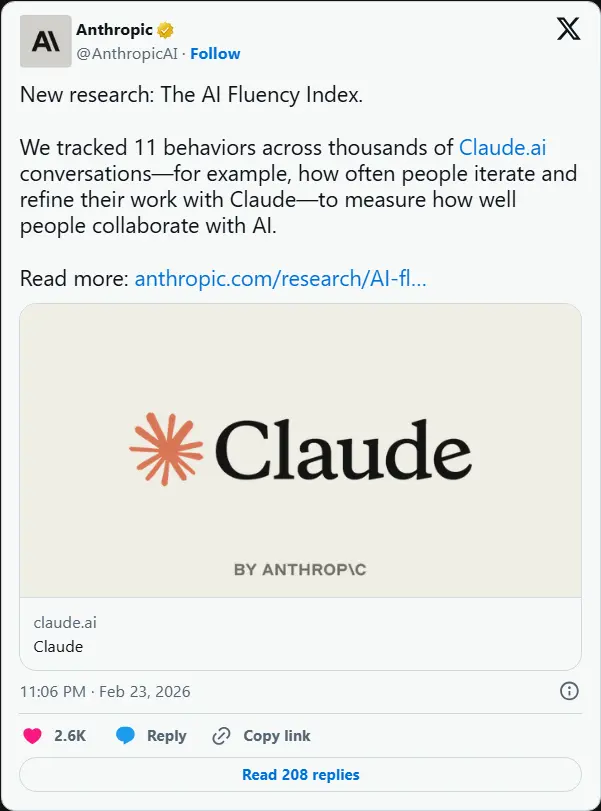
这是什么?
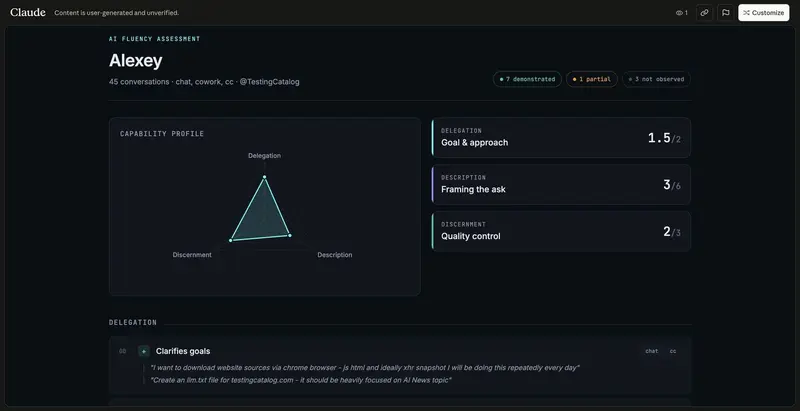
在 Claude 的设置面板中,未来可能会出现一个专用屏幕。你可以要求 Claude 生成一份个人报告。系统会分析你在 Chat、Cowork 和 Claude Code 中的会话活动,基于一套定义好的行为指标进行评分,最终生成一份结构化报告。
比如,你可能会看到:“你在 11 项指标中获得了 7.5 分。”
它评什么?
这套评分体系并非凭空而来,而是基于 Anthropic 今年 2 月发布的 4D AI 素养框架。该框架由 Anthropic 与学者共同构建,涵盖了三大支柱:
- 委托(Delegation):如何有效地将任务交给 AI。
- 描述(Description):如何清晰地描述问题和背景。
- 辨别(Discernment):如何批判性地检查和控制输出质量。
具体评估的 11 种可观察行为包括:
- 设定清晰的目标和方案。
- 构建有效的对话框架。
- 应用质量控制(如迭代优化、事实核查)。
为什么这么做?
Anthropic 的研究发现,迭代和优化是良好 AI 使用的最强预测指标。相反,那些看似精美的输出(如直接生成的代码或工件),往往会让用户降低批判性检查的频率,从而增加出错风险。
通过引入计分卡,Anthropic 试图将这一研究发现转化为一个个人反馈循环。
- 对于新手:它能具体指出哪些习惯是有效的,哪些是无效的,提供针对性的改进建议。
- 对于企业:它可以帮助团队标准化 AI 使用规范,提升整体协作效率和安全性和。
意义:从“工具”到“技能”
这标志着主要 AI 实验室首次尝试对人类在对话中的表现进行评分。
过去,我们将 AI 视为一个即插即用的工具。现在,Anthropic 正在推动一种观念转变:使用 AI 是一项需要学习和磨练的技能。
就像学习编程或写作一样,你需要反馈、练习和改进。Claude 的计分卡,本质上就是一个私人的 AI 教练。
虽然目前尚不清楚该功能的具体发布时间和覆盖范围(是面向所有用户还是仅限企业/新用户),但其方向令人兴奋。
在 AI 日益普及的今天,人与人之间的差距,可能不再取决于谁拥有更强大的模型,而取决于谁更懂得如何与模型协作。
下次当你打开 Claude 时,不妨想想:如果有一个计分卡,你会得多少分?也许,提升这个分数,比升级订阅套餐更重要。
© 版权声明
文章版权归作者所有,未经允许请勿转载。