英伟达正式发布了 Nemotron-Labs-Diffusion,这是一款突破性的“三模式”语言模型系列(包含 3B、8B、14B 密集模型)。它首次将** autoregressive (AR,自回归)**、Diffusion(扩散) 和 Self-Speculative(自我推测) 三种生成模式融合在同一个模型中。
- 模型:https://huggingface.co/collections/nvidia/nemotron-labs-diffusion
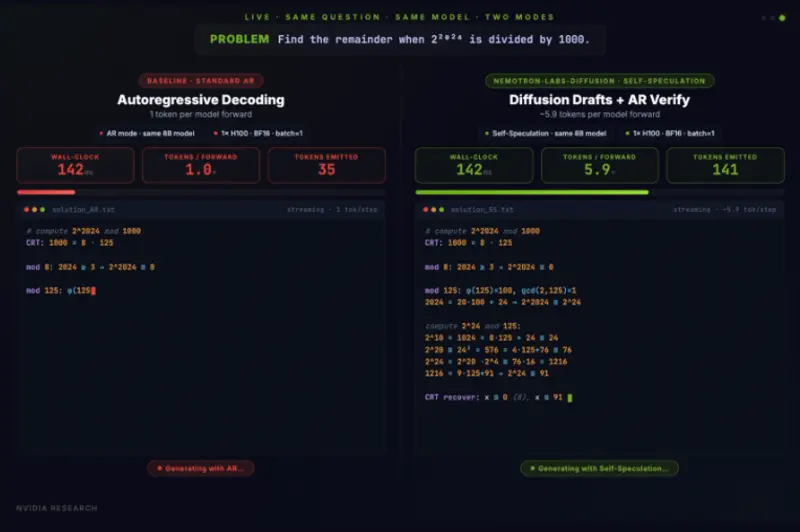
通过仅在推理期间切换注意力模式,该模型无需更换架构或加载额外模型,即可在不同场景下实现解码效率的最大化。这一创新标志着大模型推理从“内存受限”向“计算受限”的转变,显著提升了吞吐量并降低了延迟。
核心突破:一体三用的生成范式
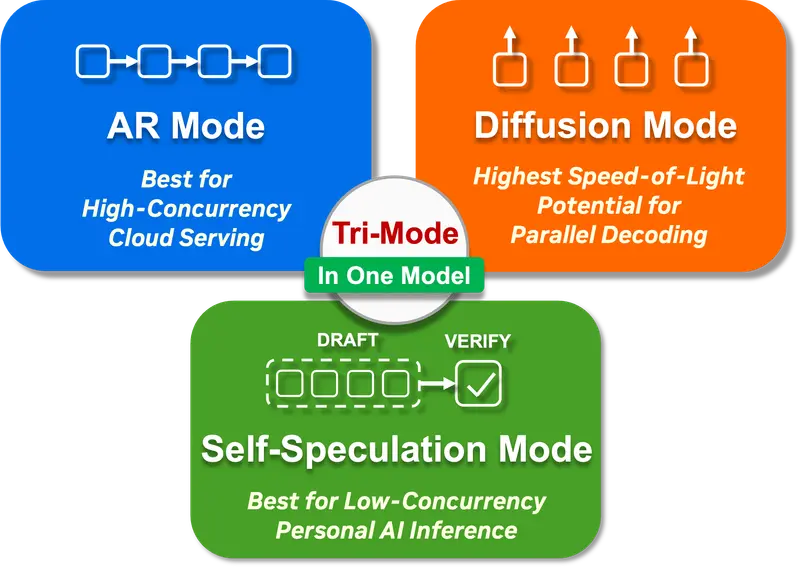
传统大模型通常只能采用单一的自回归方式逐词生成,速度慢且难以并行;而纯粹的扩散模型虽然速度快,但在语言逻辑一致性上往往稍逊一筹。Nemotron-Labs-Diffusion 通过协同训练,让单一模型具备了三种互补的能力:
1. 顺序模式 (AR Mode)
- 机制:传统的从左到右逐词生成。
- 优势:保证最高的语言逻辑精度和稳定性。
- 适用场景:高并发服务器场景,或对准确性要求极高的任务。
2. 扩散模式 (Diffusion Mode)
- 机制:基于扩散模型的并行解码,一次性生成多个 Token。
- 优势:大幅打破串行瓶颈,速度显著提升。
- 适用场景:需要平衡速度与准确率的大批量生成任务。
3. 自我推测模式 (Self-Speculative Mode)
- 机制:这是该模型的核心创新。同一模型先利用扩散能力并行起草多个 Token(草稿),再利用 AR 能力共享 KV 缓存进行快速验证(校对)。
- 优势:无需额外的辅助小模型(如主流 MTP 方法所需),即可实现极高的接受长度和解码效率。
- 适用场景:对延迟极度敏感、追求极致吞吐量的实时交互场景。
性能表现:效率碾压主流方案
测试数据显示,Nemotron-Labs-Diffusion 在速度和效率上实现了质的飞跃:
- 对比主流加速方案:
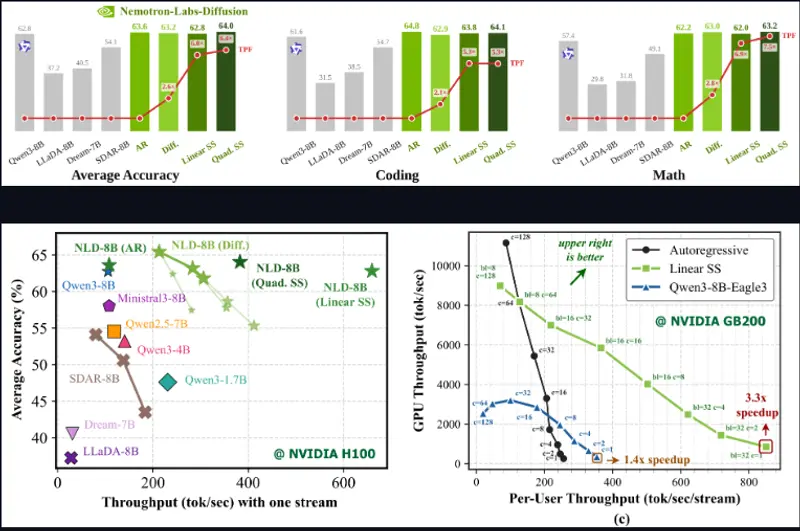
- 与 SGLang 中的 Qwen3-8B-Eagle3 相比,接受长度提高了 3 倍,速度提升了 2.2 倍。
- 在相同精度下,每前向传播生成的 Token 数比 Qwen3-8B 高出 5.9 倍。
- 实际设备加速效果:
- DGX Spark (w4a16):速度从 AR 模式的 41.8 token/秒 提升至 112 token/秒(2.7 倍)。
- GB200:AR 模式为 253 token/秒,Eagle3 为 360 token/秒,而自我推测模式达到 850 token/秒(3.3 倍)。若结合自定义 CUDA 内核优化,速度可进一步提升至 1015 token/秒(4 倍)。
- 潜力分析:
理论分析表明,通过优化采样策略,单个用户的吞吐量仍有翻倍空间,未来优化潜力巨大。
工作原理:协同训练与无缝切换
Nemotron-Labs-Diffusion 的实现依赖于“双目标训练”和“注意力模式切换”:
- 双目标协同训练:
模型同时使用顺序生成和扩散生成两种损失函数进行训练。首先建立扎实的顺序生成基础,确保语言逻辑不丢失;随后引入并行扩散能力,使模型学会“多线程”思考。 - 轻量级模式切换:
无需重新加载模型权重,仅需改变注意力掩码(Attention Mask)即可在三种模式间无缝切换。这意味着模型权重只需加载一次,即可在生成期间重复用于计算多个 Token,极大降低了内存开销。 - 自我推测流程:
- 起草:扩散模块并行生成一段 Token 草稿。
- 验证:AR 模块利用共享的 KV 缓存,快速验证草稿的正确性。
- 修正:接受的 Token 直接输出,错误的部分被修正,从而实现一步生成多词。
通用性与多模态支持
除了文本任务,Nemotron-Labs-Diffusion 还展示了强大的通用性:
- 全尺寸领先:3B、8B、14B 三个版本在 Coding、数学、综合问答等基准测试中,均超越了同等规模的开源顺序模型和扩散模型。
- 多模态扩展:图文多模态模型同样支持这三种模式,速度提升幅度在 3–7 倍之间,且精度几乎未受影响。
© 版权声明
文章版权归作者所有,未经允许请勿转载。