在 AIGC 领域,文本生成视频已屡见不鲜,但高质量的联合音视频生成仍面临巨大挑战:视频画质差、音频失真、尤其是音画不同步(如口型对不上、动作与音效错位)。传统强化学习在多模态场景中常因目标冲突和梯度干扰而失效。
- 项目主页:https://zghhui.github.io/OmniNFT/
- GitHub:https://github.com/zghhui/OmniNFT
- 模型:https://huggingface.co/zghhui/OmniNFT
由中国科学技术大学、北京大学和京东联合研究的 OmniNFT 框架正式提出。这是一种新颖的模态感知在线扩散强化学习框架,旨在解决多模态生成中的优势不一致、梯度不平衡及信用分配难题。实验表明,OmniNFT 能在不增加计算负担的前提下,显著提升视频画质、音频质量及音画同步性。
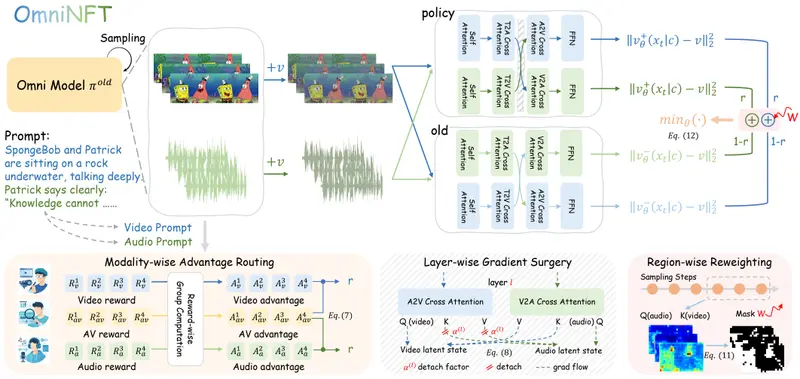
核心亮点:模态感知、梯度隔离、精准同步
1. 模态感知优势路由 (Modal-Aware Advantage Routing)
- 痛点:传统方法将所有奖励折叠为单一全局优势,导致视频和音频接收到的优化信号可能相互矛盾(例如,视频好但音频差,全局优势可能误导音频分支)。
- 解决方案:OmniNFT 为视频、音频和跨模态同步计算独立的每奖励优势。
- 单模态优势仅监督各自的生成分支。
- 同步优势则广播给两者。
- 效果:解决了约一半样本中存在的模态间奖励不一致问题,确保各模态“各司其职”又“协同作战”。
2. 层级梯度修正 (Hierarchical Gradient Correction)
- 痛点:视频分支的梯度容易泄漏到负责模态内生成的浅层音频层,导致音频音质受损(梯度不平衡)。
- 解决方案:在浅层 Transformer 块的音频到视频(A2V)交叉注意力中,对音频键值投影应用部分停止梯度。
- 抑制:阻止错误的视频梯度注入浅层音频层,保护音频底层特征。
- 保留:允许深层跨模态对齐层的完整梯度流,确保音画交互。
- 效果:音频音质更稳定,不受视频优化过程的负面干扰。
3. 区域感知损失重加权 (Region-Aware Loss Reweighting)
- 痛点:细粒度的跨模态对齐区域(如嘴巴、乐器)难以获得有效的探索和优化,传统方法往往“平均用力”。
- 解决方案:利用后期去噪步骤中的视频到音频(V2A)交叉注意力图作为发声关键区域的内在代理。
- 聚合为每 token 重要性权重。
- 调制视频分支的 RL 损失,将优化能力集中在对同步最关键的区域。
- 效果:无需外部检测模块,即可自动聚焦人物嘴巴、发声物体等关键部位,显著提升口型同步率和动作匹配度。
性能表现:全面超越 baseline
在 LTX-2 主干网络上,基于 JavisBench 和 VBench 基准的广泛实验显示:
| 指标 | 提升幅度 | 说明 |
|---|---|---|
| 视频质量 | ↑ 60%+ | 画面更清晰、动作更自然、细节更丰富 |
| 音频质量 | ↑ ~10% | 音色更自然、环境音更真实、杂音减少 |
| 音画同步误差 | ↓ 50%+ | 口型与台词高度匹配,动作与音效精准对齐 |
| 文本一致性 | 显著提升 | 音视频内容严格贴合输入描述,无偏离主题 |
| 计算开销 | ≈ 0 | 训练时间几乎不增加,无额外推理负担 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。