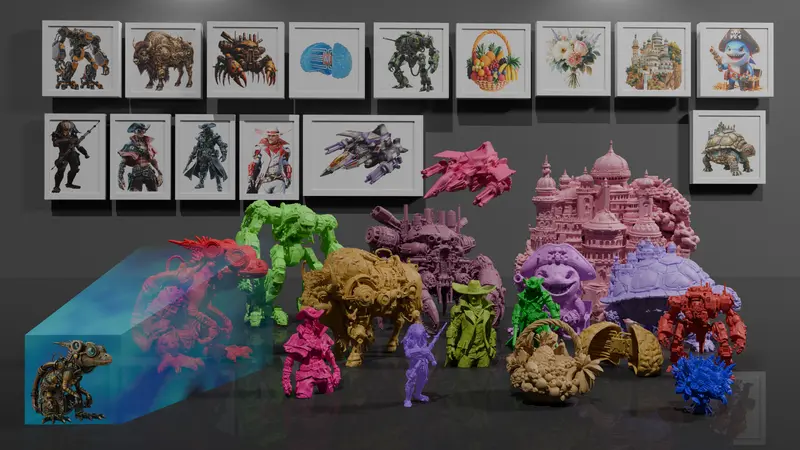
Pixal3D 是由清华大学(BNRist)、腾讯 ARC 实验室和惠灵顿维多利亚大学联合研究团队提出的一种3D 生成技术。它解决了当前 AI 图像转 3D 领域最大的痛点——像素级一致性缺失。
- 项目主页:https://ldyang694.github.io/projects/pixal3d/
- GitHub:https://github.com/TencentARC/Pixal3D
- 模型:https://huggingface.co/TencentARC/Pixal3D
- Demo:https://huggingface.co/spaces/TencentARC/Pixal3D
与传统方法通过注意力机制“松散”注入图像特征不同,Pixal3D 引入了像素反投影条件机制,将 2D 图像特征显式提升到 3D 空间,建立了无歧义的“像素-3D”直接对应关系。这使得生成的 3D 资产在几何形状和纹理细节上达到了接近专业 3D 扫描重建的保真度。
核心突破:从“猜着生成”到“精准映射”
1. 像素级对齐 (Pixel-Aligned)
- 解决对应难题:传统模型在规范空间生成形状,导致 2D 像素与 3D 点云关系模糊。Pixal3D 借鉴多视图立体重建思路,让每个像素都精准对应到 3D 空间的具体位置。
- 拒绝变形错位:确保生成的 3D 模型在输入视角下与原图完全一致,彻底消除“画得像但结构歪”的现象。
2. 像素反投影条件机制
- 显式特征提升:将多尺度图像特征沿着视线方向“反投影”到 3D 特征体积中。
- 多尺度细节保留:既能捕捉物体的宏观轮廓,又能还原键盘纹路、花瓣脉络等微观细节。
3. 原生支持多视图融合
- 跨视图聚合:当输入多张不同角度照片时,Pixal3D 能自然地将各视角的反投影特征体积进行聚合,无需复杂的姿态估计即可大幅提升生成精度。
主要功能
| 功能 | 描述 |
|---|---|
| 单图高保真生成 | 仅凭一张照片,生成几何与纹理均与原图像素级对齐的 3D 模型。 |
| 多视图增强生成 | 输入 2-6 张不同角度的照片,通过特征融合生成更完整、误差更低的 3D 资产。 |
| 3D 场景拆解与合成 | 自动识别场景图中的多个物体,分别生成独立的高保真 3D 模型,并重组为完整场景。 |
| 可用网格输出 | 直接输出带有 PBR 纹理的高质量网格模型(Mesh),而非稀疏点云,可直接用于游戏或影视制作。 |
工作原理:给 3D 模型“按图钉”
Pixal3D 的核心逻辑可以通俗地理解为**“按图钉”**过程:
- 反向投射:将输入图像的每一个像素,沿着相机视线方向投射到 3D 空间中,形成一条条确定的射线。
- 约束生成:强制 3D 生成器在这些射线上构建几何形状,确保图片上的点与 3D 模型上的点严格重合。
- 特征注入:利用多尺度图像特征(从整体轮廓到局部纹理)填充 3D 空间。
- 视角保持:不强制将物体旋转到标准正面,而是直接依据输入视角生成,避免了因姿态估计错误导致的形变。
- 多视融合:若有多个视角,则将多个视角的“射线约束”叠加,取交集或平均值,从而获得全方位的高精度模型。
性能评估
- 保真度 SOTA:在标准测试集上,Pixal3D 的形状匹配度(Chamfer Distance)和纹理相似度(PSNR/SSIM)全面领先现有顶尖方法。
- 用户偏好最高:在主观评测中,用户在“像不像原图”和“模型美观度”两项指标上均给予 Pixal3D 最高评分。
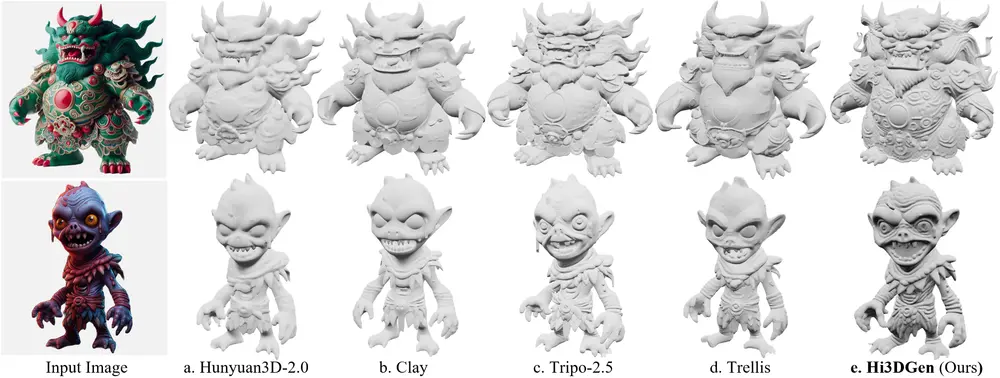
- 细节还原卓越:在处理复杂拓扑结构(如镂空物体、精细花纹)时,Pixal3D 能清晰呈现其他方法容易模糊或丢失的细节。
- 多图增益明显:随着输入视图数量增加(2→4→6 张),生成误差显著降低,模型完整性大幅提升。
版本说明
| 分支 | 描述 | 适用场景 |
|---|---|---|
| main | 最新版本:基于 Trellis.2 主干网络,性能更强,生成速度更快,推荐大多数用户使用。 | 日常开发、高性能需求 |
| paper | 论文版本:基于 Direct3D-S2,复现 SIGGRAPH 2026 论文中的实验结果。 | 学术研究、对比实验 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。