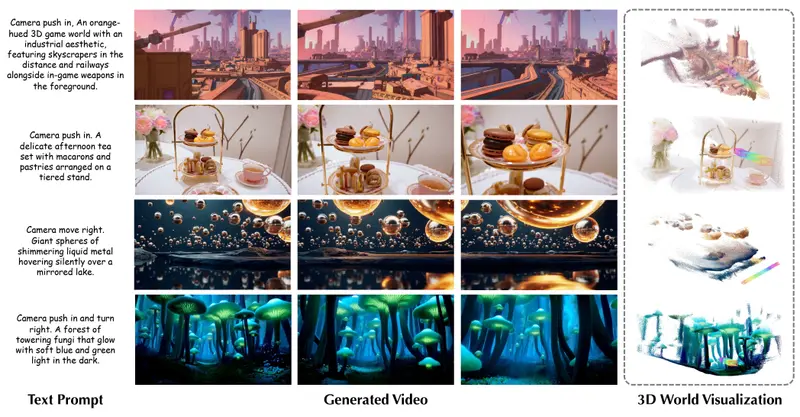
World-R1 是由浙江大学与微软研究人员联合提出的一种创新框架,解决当前视频基础模型在生成过程中常见的几何不一致问题(如物体变形、空间错乱、穿模等)。它通过**强化学习(RL)**将 3D 物理约束注入视频生成过程,在不改变底层模型架构、不依赖昂贵 3D 标注数据的前提下,显著提升了生成视频的 3D 一致性与镜头控制精度。
- 项目主页:https://microsoft.github.io/World-R1/index.html
- GitHub:https://github.com/microsoft/World-R1
World-R1 标志着 AI 视频生成从“画帧”向“世界模拟”迈出了关键一步,让生成的视频不仅好看,更符合真实世界的空间逻辑。
核心亮点
1. 不改架构,即插即用
- 零结构修改:无需重新设计网络或添加复杂的控制模块(如 ControlNet),直接在现有视频大模型基础上进行优化。
- 低成本训练:仅使用纯文本数据集,通过强化学习反馈机制实现 3D 对齐,避免了海量 3D 资产标注的高昂成本。
2. 精准镜头控制与 3D 一致性
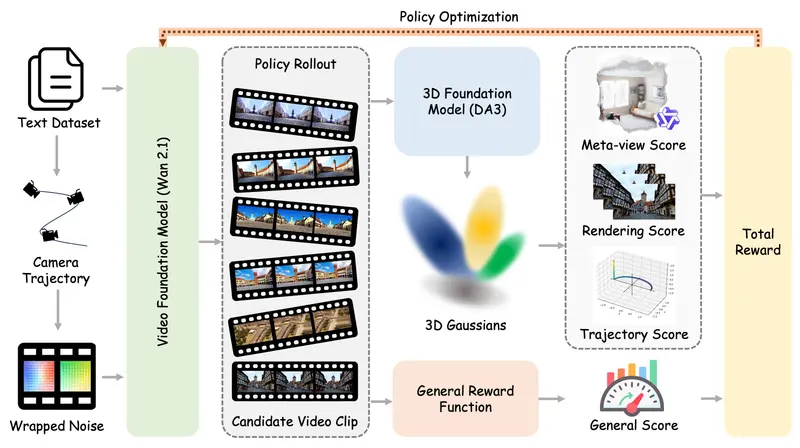
- 隐式相机条件:将文本中的运动指令(推进、拉远、平移、环绕)解析为确定性相机外参,并通过轨迹引导的包装写入初始噪声中,实现精准的镜头运动控制。
- 几何稳定性:物体在镜头移动过程中保持形状、大小和位置的稳定,彻底告别“墙面扭曲”和“物体消失”。
3. 动态与静态的完美平衡
- 周期性解耦训练:采用独特的训练策略,每隔 100 步暂时禁用严格的 3D 约束,专门针对高熵动态提示(如水流、人物动作)进行优化。
- 拒绝僵硬:既保证了静态场景的空间逻辑,又保留了动态场景的自然流畅度,避免画面因过度约束而显得呆板。
4. 画质与逻辑兼得
- 双重奖励机制:结合 3D 感知奖励(几何合理性)与 通用质量奖励(HPSv3 美学评分),确保在矫正几何错误的同时,不牺牲画面的美观度、清晰度及主体一致性。
工作原理:强化学习 + 三维反馈
World-R1 通过以下流程实现“物理矫正”:
- 指令解析:从文本提示中提取相机运动轨迹(如“环绕拍摄”),并投影为密集光流。
- 噪声注入:将相机先验通过离散噪声传输注入初始潜在噪声,无需额外控制网络即可引导视角。
- 视频生成:使用 Flow-GRPO-Fast 采样生成分组卷展视频。
- 3D 重建与评估:
- 利用 Depth Anything 3 将视频帧重建为 3D Gaussian Splatting (3DGS)。
- 使用 Qwen3-VL 评估多视角合理性。
- 使用 LPIPS 测量重渲染保真度。
- 强化学习优化:将 3D 感知奖励与 HPSv3 视觉质量反馈结合,通过 PPO/GRPO 算法优化模型,使其逐渐掌握“正确的 3D 规则”。
性能评估
经过大量对比测试,World-R1 展现了卓越的性能:
| 指标 | 表现 | 说明 |
|---|---|---|
| 3D 一致性 | 提升 ~10dB | 关键几何指标大幅优于基线模型,物体几乎不再变形。 |
| 镜头执行准确率 | 76% | 用户测试中,绝大多数人认为其能更精准地执行镜头指令。 |
| 几何稳定性偏好 | 92% | 92% 的用户认为其比原版模型更稳定,空间感更真实。 |
| 画质保持 | SOTA 水平 | 美观度、清晰度及运动流畅度均保持在顶级水平,无明显下降。 |
| 长视频稳定性 | 优异 | 在生成长序列视频时,依然能维持稳定的 3D 空间结构。 |
数据集分类
为了促进世界模拟能力的对齐,研究团队引入了专门定制的纯文本数据集,涵盖多种场景:
- 自然景观:地貌、水体、天气变化。
- 城市与建筑:城市景观、室内空间、基础设施。
- 微观与静物:桌面静物、材质表现、微观世界。
- 奇幻与超现实主义:非欧几里得空间、反物理场景。
- 艺术风格:超越照片写实主义的风格化渲染。
- 动态数据子集:用于周期性动态调整的高熵场景。
应用前景
- 影视预演与创作:生成符合物理规律的镜头语言,辅助导演进行分镜设计。
- 虚拟世界构建:为游戏引擎或元宇宙平台提供高质量、几何一致的动态素材。
- 自动驾驶仿真:生成符合真实世界几何逻辑的交通场景视频,用于算法测试。
- 电商展示:生成稳定、无变形的产品 360 度展示视频。
© 版权声明
文章版权归作者所有,未经允许请勿转载。