深度求索(DeepSeek)今日正式发布了全新系列模型 DeepSeek-V4 的预览版本,并同步开源了模型权重。作为 DeepSeek 的最新旗舰系列,V4 在 Agent 能力、世界知识和推理性能上均实现了突破,确立了其在开源领域及国内市场的领先地位。
- 官方介绍:https://mp.weixin.qq.com/s/8bxXqS2R8Fx5-1TLDBiEDg?scene=1
DeepSeek-V4 系列包含两个版本:V4-Pro(高性能旗舰)与 V4-Flash(高效经济版),均标配 1M(一百万)超长上下文窗口。
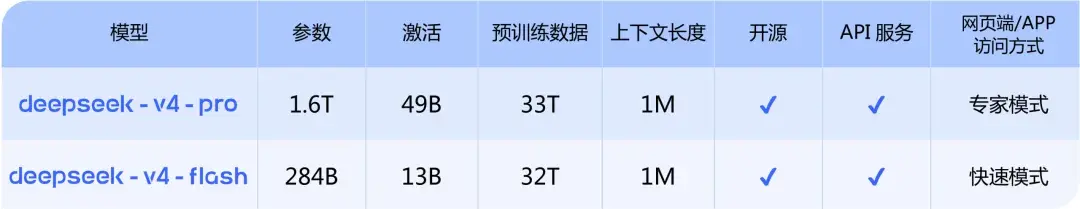
核心亮点
1. DeepSeek-V4-Pro:比肩顶级闭源模型
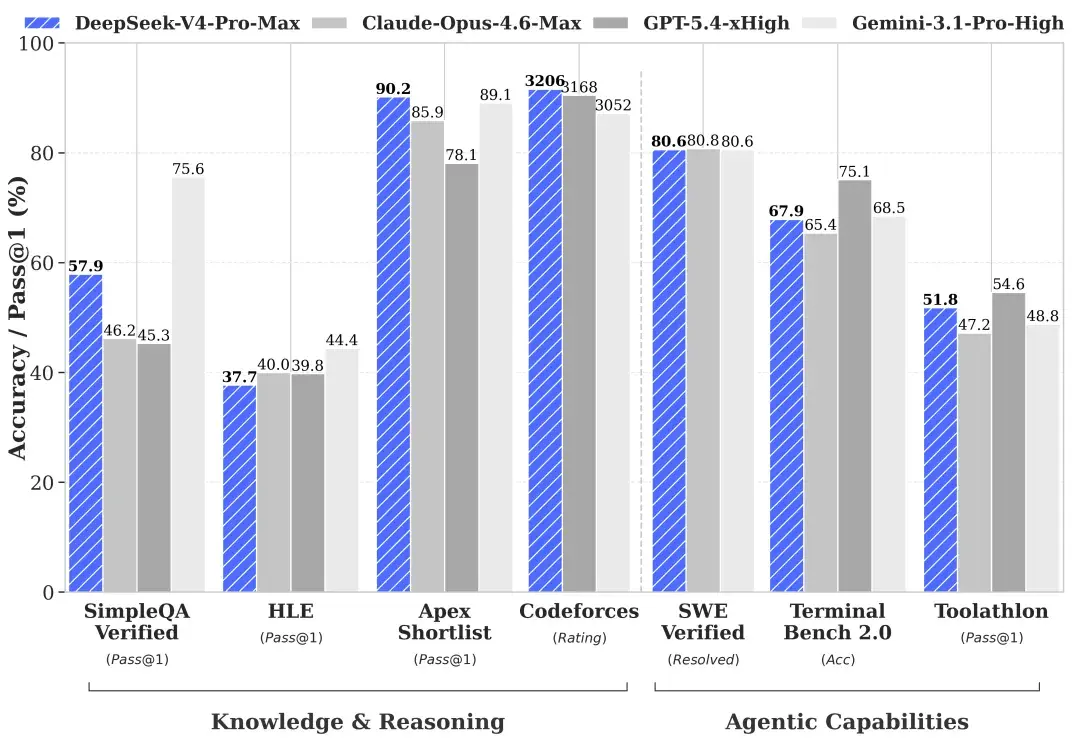
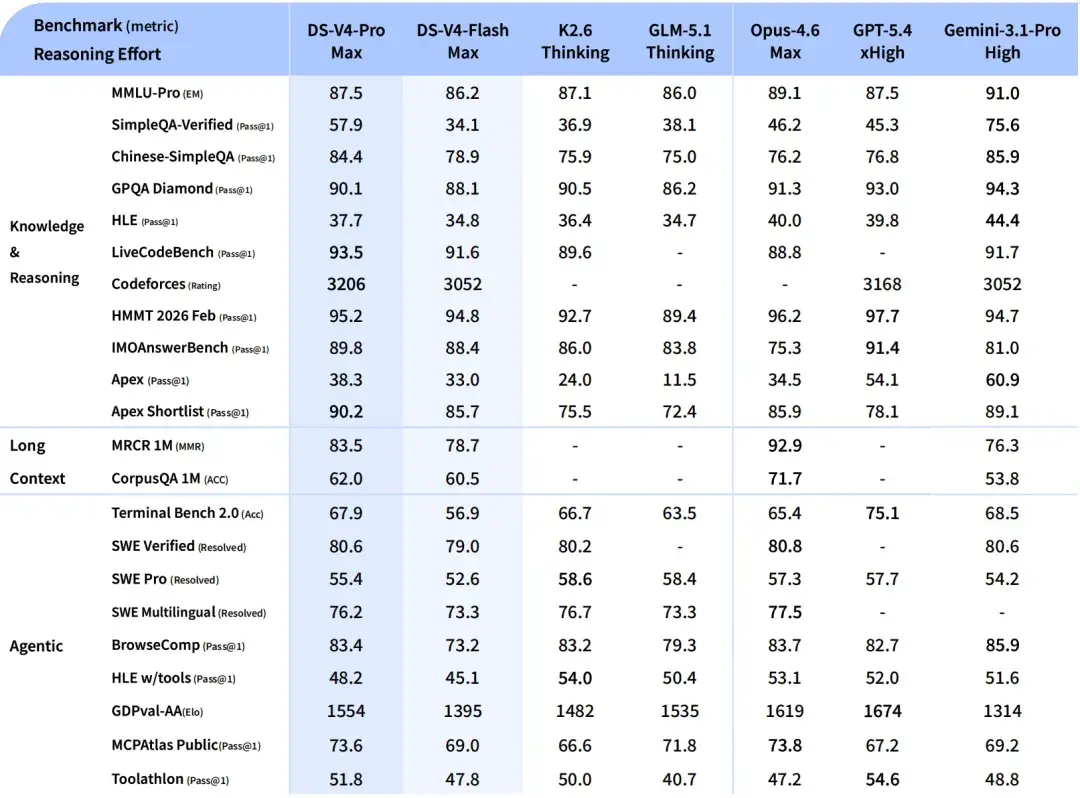
- Agent 能力跃升:在 Agentic Coding 评测中达到当前开源模型最佳水平。内部测试显示,其使用体验优于 Claude Sonnet 4.5,交付质量接近 Claude Opus 4.6(非思考模式),是公司内部首选的 Agentic Coding 模型。
- 世界知识丰富:在世界知识测评中大幅领先其他开源模型,仅稍逊于 Gemini-Pro-3.1。
- 顶级推理性能:在数学、STEM 及竞赛型代码测评中,超越所有已公开评测的开源模型,性能比肩世界顶级闭源模型。
2. DeepSeek-V4-Flash:快捷高效的经济之选
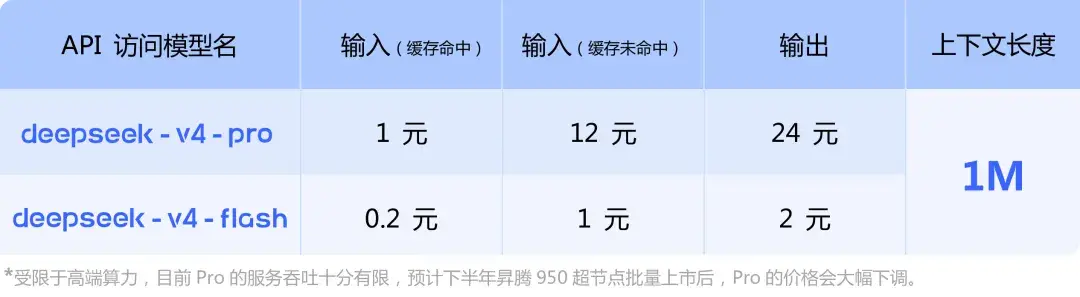
- 高性价比:相比 Pro 版本,Flash 拥有更小的参数量和激活量,提供更快的推理速度和更低的 API 成本。
- 能力均衡:在世界知识储备上略逊于 Pro,但推理能力接近。在简单 Agent 任务上与 Pro 旗鼓相当,适合高并发、对延迟敏感的场景。
3. 1M 超长上下文与结构创新
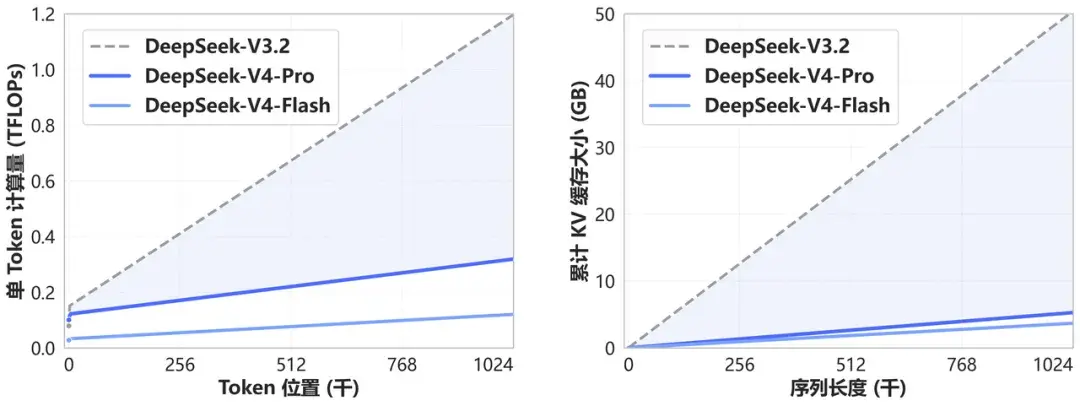
- DSA 稀疏注意力:开创性地引入 Token 维度压缩与 DeepSeek Sparse Attention (DSA) 机制,大幅降低长上下文的计算与显存需求。
- 标配 1M 上下文:从现在开始,1M 上下文成为 DeepSeek 所有官方服务的标配,支持海量文档、代码库及长视频内容的完整理解。
4. Agent 专项优化
- 主流框架适配:针对 Claude Code、OpenClaw、OpenCode、CodeBuddy 等主流 Agent 产品进行了深度适配。
- 任务表现提升:在代码生成、文档撰写、PPT 制作等复杂 Agent 工作流中表现显著提升。
API 调用指南
DeepSeek API 已同步上线 V4-Pro 与 V4-Flash,支持 OpenAI ChatCompletions 接口与 Anthropic 接口。
基本配置
- Base URL: 保持不变
- Model 参数:
deepseek-v4-prodeepseek-v4-flash
思考模式 (Thinking Mode)
两个版本均支持非思考模式与思考模式。
- 参数设置: 通过
reasoning_effort参数控制思考强度(可选值:high,max)。 - 建议: 对于复杂的 Agent 场景或高难度推理任务,建议开启思考模式并设置为 `max。
⚠️ 重要通知:旧模型名弃用
- 弃用模型:
deepseek-chat与deepseek-reasoner - 过渡期: 当前阶段,
deepseek-chat指向deepseek-v4-flash(非思考),deepseek-reasoner指向deepseek-v4-flash(思考)。 - 停止服务时间: 2026年7月24日。请务必在此之前更新代码中的 model 名称。
开源与本地部署
DeepSeek-V4 系列模型权重已全面开源,支持社区进行本地部署与二次开发。
- Hugging Face: deepseek-ai/deepseek-v4
- ModelScope: DeepSeek-V4 Collection
- 技术报告: DeepSeek_V4.pdf
体验方式
- 在线对话: 登录 chat.deepseek.com 或使用官方 App,即可体验 1M 超长上下文记忆。
- API 集成: 开发者可通过修改
model_name快速接入最新能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。