FL VoxCPM 是一款基于 OpenBMB VoxCPM 系列模型的ComfyUI 自定义节点,为工作流带来了高质量的文本转语音 (TTS)、语音克隆及 LoRA 微调能力。它支持 V1 和 V2 两个版本的模型,能够满足从快速语音合成到专业级语音定制的各种需求。
- GitHub:https://github.com/filliptm/ComfyUI-FL-VoxCPM
ComfyUI-VoxCPM:集成 VoxCPM 的上下文感知语音合成节点
核心功能
1.双版本模型支持
- VoxCPM V2 (推荐):20 亿参数模型,支持 48kHz 录音室级音频输出,覆盖 30 种语言。具备语音设计、可控克隆等高级功能。
- VoxCPM V1.5:8 亿参数模型,44.1kHz 高保真输出,稳定性强,适合对资源要求较低的场景。
2. 多样的语音生成模式 (V2)
- 语音设计 (Voice Design):无需参考音频,仅通过自然语言描述(如“温暖温柔的年轻女性声音”)即可生成定制化语音。
- 语音克隆 (Voice Cloning):上传短音频参考,快速克隆目标音色。
- 可控克隆 (Controllable Cloning):在克隆音色的基础上,通过文本描述调整情感或风格(如“悲伤地”、“兴奋地”)。
- 终极克隆 (Ultimate Cloning):结合参考音频、参考文本及提示音频/文本,实现最高保真度的音色还原。
3. LoRA 微调与训练
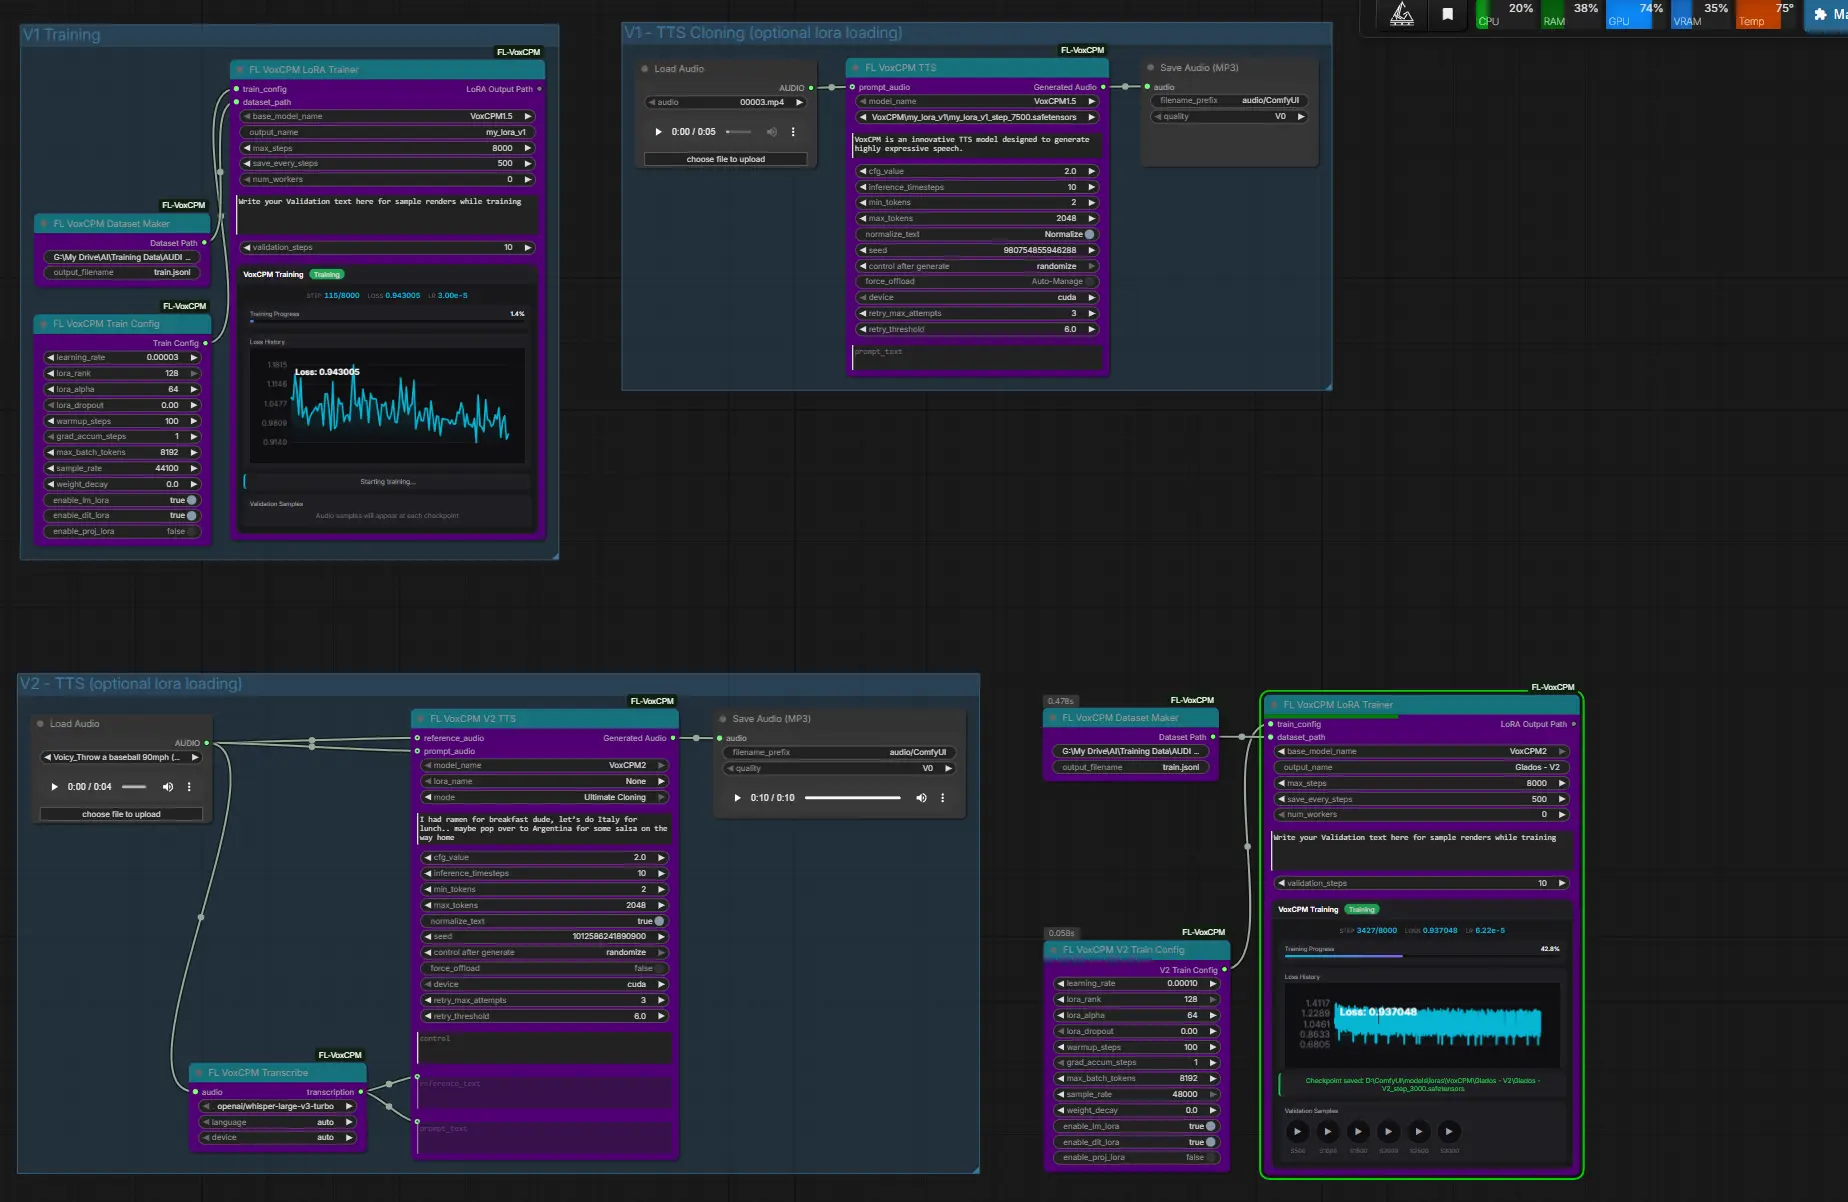
- 实时训练仪表板:内置训练监控界面,实时显示损失曲线、进度条及验证音频样本。
- 一键数据集制作:提供
FL VoxCPM Dataset Maker节点,自动处理音频与转录文件。 - 统一训练器:支持 V1 和 V2 模型的 LoRA 微调,训练好的模型自动保存至
ComfyUI/models/loras/VoxCPM/。
4. 辅助音频工具
- 自动转录:集成 Whisper 模型,可将参考音频自动转换为文本,简化克隆流程。
- 音频裁剪:精确裁剪音频片段,用于制作高质量的参考素材。
安装方法
方式一:ComfyUI Manager (推荐)
- 打开 ComfyUI Manager。
- 搜索 “FL VoxCPM”。
- 点击 Install 并重启 ComfyUI。
方式二:手动安装
cd ComfyUI/custom_nodes
git clone https://github.com/filliptm/ComfyUI-FL-VoxCPM.git
cd ComfyUI-FL-VoxCPM
pip install -r requirements.txt
重启 ComfyUI。首次运行节点时,模型会自动从 HuggingFace 下载至 ComfyUI/models/tts/VoxCPM/。
快速开始指南
场景一:V2 语音设计 (无参考音频)
- 添加
FL VoxCPM V2 TTS节点。 - 将
mode设置为Voice Design。 - 在
control输入框中填写语音描述(例如:”a deep male voice, serious tone”)。 - 输入目标文本
text,点击队列提示。
场景二:V2 语音克隆
- 添加
FL VoxCPM V2 TTS和Load Audio节点。 - 将
mode设置为Voice Cloning。 - 将加载的参考音频连接到节点的
reference_audio输入端。 - 输入目标文本
text,点击队列提示。
场景三:LoRA 训练
- 准备数据集文件夹,包含成对的音频文件 (.wav/.mp3/.flac) 和对应的转录文本 (.txt)。
- 连接节点链:
FL VoxCPM Dataset Maker→FL VoxCPM V2 Train Config→FL VoxCPM LoRA Trainer。 - 在 Trainer 节点中设置
validation_text,以便训练过程中听到样本效果。 - 启动训练,通过实时仪表板监控进度。训练完成后,LoRA 文件将自动保存。
关键参数说明
| 参数 | 默认值 | 描述 |
|---|---|---|
cfg_value | 2.0 | 引导比例。值越高越贴近参考语音/描述,值越低越自然多样。 |
inference_timesteps | 10 | 扩散步数。增加步数可提升音质,但会延长生成时间。 |
lora_name | – | 选择已训练的 LoRA 模型(系统自动检测 Rank)。 |
control | – | (仅 V2) 用于语音设计或风格控制的自然语言描述。 |
硬件要求
- 内存:最低 16GB,训练建议 32GB+。
- 显存 (VRAM):
- V1 推理:支持 CPU 及 Mac MPS,GPU 建议 8GB+。
- V2 推理:建议 10GB+ 显存。
- V2 训练:建议 20GB+ 显存。
- Python:3.9+
© 版权声明
文章版权归作者所有,未经允许请勿转载。