你的 Claude Code 最近是不是变得“懒”了?
推理变浅、任务中途放弃、Token 消耗激增……过去几周,越来越多的开发者在 GitHub、X 和 Reddit 上抱怨:Claude Opus 4.6 和 Claude Code 的性能似乎出现了显著下降。
有人称之为“AI 缩水式通胀”(Shrinkflation)——你付着同样的钱,却得到了更弱的服务。甚至有人怀疑,Anthropic 为了应对算力瓶颈,正在暗中“削弱”模型。
面对铺天盖地的指责,Anthropic 高层罕见地集体出面反驳,称这些说法是“纯粹的点击诱饵”。但这场争论并非空穴来风,它揭示了 AI 时代用户与提供商之间日益扩大的信任鸿沟。
指控:来自 AMD 高管的详尽数据
最有力的指控来自 AMD AI 集团高级总监 Stella Laurenzo。她在 GitHub 上发布了一篇长文,基于对 6,852 个会话、17,871 个思考块和 23 万次工具调用的分析,指出:
- 推理深度骤降:自 2 月以来,Claude 的“思考”明显变少,更倾向于给出“最简单的修复”,而非深入解决复杂工程问题。
- 行为模式改变:从“研究优先”转向“编辑优先”,更容易产生幻觉或自相矛盾。
- 可靠性降低:过早停止任务的情况大幅增加。
Laurenzo 认为,对于高级编码工作流,扩展推理(Extended Reasoning)不是奢侈品,而是核心能力。如果这一能力被削弱,Claude 将不再值得信任。
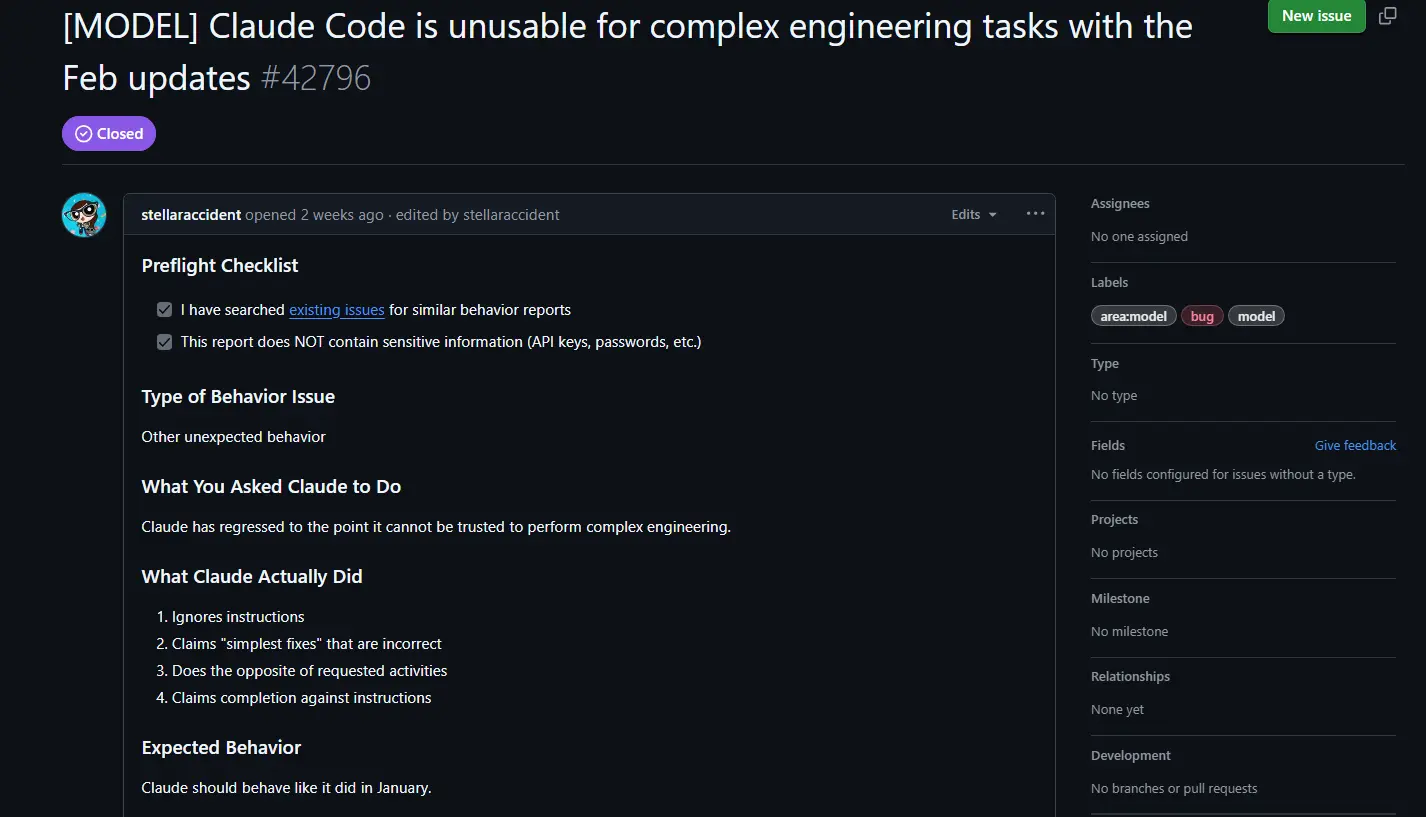
地址:https://github.com/anthropics/claude-code/issues/42796#issuecomment-4194007103
此外,基准测试平台 BridgeBench 的数据也推波助澜:声称 Claude Opus 4.6 的准确率从 83.3%(第 2 名) 暴跌至 68.3%(第 10 名)。
反驳:Anthropic 的“产品调整”论
面对指控,Anthropic 的核心团队成员迅速回应,坚决否认“秘密降级”的说法。
- Boris Cherny (Claude Code 负责人):称 Laurenzo 的结论基于误解。他指出,2 月 12 日的 UI 更新只是隐藏了部分思考过程以减少延迟,并未改变底层推理能力。
- 默认设置变更:Cherny 承认,为了平衡成本和速度,Anthropic 在 3 月 3 日将 Opus 4.6 的默认“努力程度”从“高”调整为“中”(Effort Level 85)。但这并非削弱模型,而是优化体验。用户可以通过
/effort high手动恢复高强度推理。 - Thariq Shihipar (技术人员):明确表示,“我们不会为了管理需求而降低模型性能。”
关于基准测试暴跌的说法,外部研究员 Paul Calcraft 指出其方法论存在严重缺陷:早期结果仅基于 6 个任务,而后期基于 30 个任务,两者不具备直接可比性。在共同的 6 个任务中,分数仅从 87.6% 微降至 85.4%,属于正常统计噪声。
幕后真相:缓存、限流与信任危机
虽然 Anthropic 否认“削弱模型”,但它确实承认了一系列产品层面的调整,这些调整直接影响了用户体验:
- 会话限流:3 月底,Anthropic 调整了高峰时段(工作日 5am-11am PT)的会话限制,约 7% 的 Pro 用户会更快耗尽额度。这引发了用户对“算力不足”的联想。
- 缓存策略变更:GitHub 用户发现,Claude Code 的提示缓存 TTL(生存时间)从 1 小时缩短至 5 分钟。Anthropic 解释这是为了优化整体缓存命中率,但导致长期会话的 Token 成本上升。
- UI 隐藏思考:为了提升响应速度,部分中间思考步骤不再实时显示,让用户感觉模型“没怎么想”就给出了答案。
感知的落差
这场争论的核心,或许不在于模型权重是否被修改,而在于用户感知与产品策略之间的错位。
- 用户视角:我花了同样的钱,但模型变得更懒、更贵、更不可靠了。这就是“降级”。
- Anthropic 视角:我们优化了默认设置以平衡成本和速度,提供了更高效的缓存策略,并保留了高阶选项。这是“产品迭代”。
在 OpenAI 等竞争对手步步紧逼的背景下,Anthropic 必须小心处理这种信任危机。对于依赖 Claude 进行高强度编码的开发者来说,透明的沟通和可控的参数(如努力程度、缓存策略)比任何公关声明都更重要。
下次当你觉得 Claude “变笨”时,不妨试试输入 /effort high。也许,它只是被默认设置“束缚”了手脚。
© 版权声明
文章版权归作者所有,未经允许请勿转载。