谷歌最新发布的 Gemma 4 系列模型以其卓越的性价比震撼了开源社区。特别是 Gemma 4 26B A4B(Active 4 Billion)版本,它利用混合专家(MoE)架构,在推理时仅激活约 40 亿参数,却拥有 260 亿参数的知识储备和质量。这意味着你可以在消费级硬件上获得接近旗舰模型的性能,同时保持极快的响应速度。
结合 OpenClaw 强大的智能体编排能力,你可以轻松在本地搭建一个完全私有、高效且低延迟的 AI 助手。以下是只需几分钟即可完成的三步指南。
快速开始:三步部署
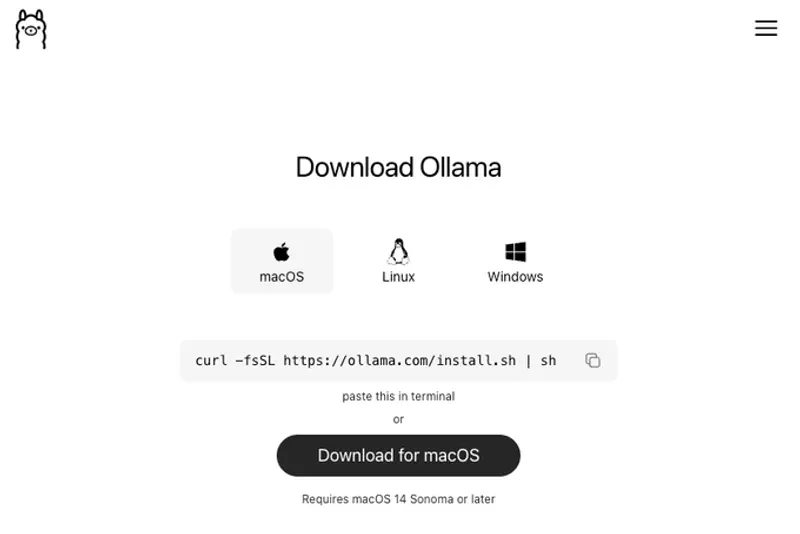
第 1 步:安装 Ollama
Ollama 是目前最流行的本地大模型运行工具,简化了模型的下载和管理。
- 访问 ollama.com/download
- 根据你的操作系统(macOS, Windows, Linux)下载并安装 Ollama。
第 2 步:准备 Gemma 4 模型(可选)
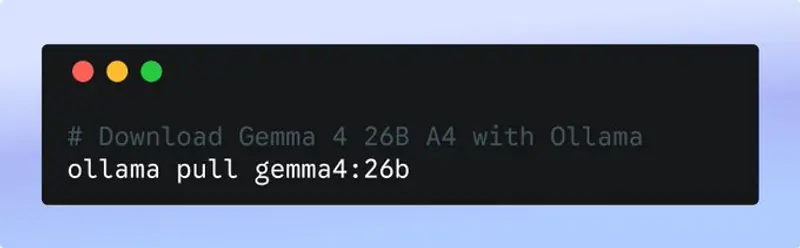
虽然第 3 步会自动处理,但你可以预先下载以确保网络稳定。Gemma 4 26B A4B 是平衡速度与质量的绝佳选择。
- 打开终端或命令行。
- 运行命令:
ollama pull gemma4:26b-a4b
第 3 步:一键启动 OpenClaw + Gemma 4
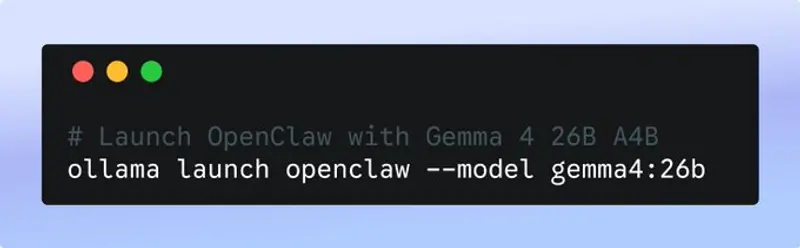
这是最神奇的一步。OpenClaw 提供了极简的启动脚本,能够自动配置环境并连接后端。
- 在终端中运行 OpenClaw 的启动命令:
ollama launch openclaw --model gemma4:26b - 自动化流程:该命令将自动检查并安装 OpenClaw(如果尚未安装),配置 Ollama 作为后端,并加载 Gemma 4 模型。
- 完成:几分钟后,你的本地 AI 智能体即可通过命令行或 Web 界面进行交互。
硬件配置参考:你的设备能跑哪个 Gemma 4?
Gemma 4 系列提供了多种尺寸,适配从手机到工作站的各类设备。得益于 MoE 技术,大模型也能在普通电脑上流畅运行。
| 模型版本 | 活跃参数 | 推荐硬件 | 适用场景 |
|---|---|---|---|
| Gemma 4 E2B | ~2B | iPhone 15+, Pixel 8+ 等现代手机 | 移动端轻量助手、离线翻译、简单问答 |
| Gemma 4 E4B | ~4B | 大多数笔记本电脑、Mac mini M4 (8GB+) | 日常办公辅助、代码补全、笔记整理 |
| Gemma 4 26B A4B | ~4B (激活) / 26B (总参) | Mac Studio M4 Pro (48GB+)、高端 PC (RTX 4090 24GB+) | 🌟 最佳平衡点:复杂逻辑推理、长上下文分析、本地智能体核心 |
| Gemma 4 31B | ~31B | Mac Studio M4 Max (64GB+)、双 RTX 4090 | 极致性能需求、专业级代码生成、复杂任务规划 |
💡 为什么推荐 26B A4B?
它实现了“40 亿参数的速度,260 亿参数的质量”。对于本地智能体而言,这意味着更快的响应延迟(低 Token 生成时间)和更低的显存占用,同时保持了处理复杂任务所需的智力水平。
为什么选择 OpenClaw + Gemma 4?
- 完全隐私:所有数据都在本地处理,无需上传云端,适合处理敏感文档或个人数据。
- 极低延迟:本地运行消除了网络请求开销,Gemma 4 的高效架构确保了流畅的对话体验。
- 高度可定制:OpenClaw 允许你定义智能体的行为、工具和记忆系统,Gemma 4 则提供了强大的底层理解能力。
- 零成本:无需支付 API 费用,一次硬件投入,无限次使用。
随着 Gemma 4 的发布,本地 AI 智能体的门槛已大幅降低。只需三步,你就能拥有一个运行在自家机器上的强大 AI 助手。无论是用于编程辅助、学习研究还是日常创作,OpenClaw + Gemma 4 都将是你在 2026 年最值得尝试的组合。
© 版权声明
文章版权归作者所有,未经允许请勿转载。