PackyApi
PackyApi 是一款面向企业与开发者的 AI 基础设施服务,旨在通过统一的 API 网关连接全球主流大模型资源。它解决了多模型接入复杂、成本不可控、稳定性难保障等痛点,为 Claude Code、Codex、Gemini 等主流 CLI 工具及各类 AI 应用提供稳定、可观测、可扩展的底层支持。
Garlic LLM 是一个用于 PlayStation 4 的自制应用。它在主机自己的 GPU 上运行 Qwen3.5-9B,运行时无需 PC,也无需互联网。它还能听、说,并运行它编写的 Python。
 Garlic LLM
开发者 Leonardo Alegría 发布的开源项目 Garlic LLM 实现了一项令人瞩目的技术突破:在一台经过越狱的 PlayStation 4 游戏主机上,完全离线地运行拥有 90 亿参数的 Qwen3.5-9B 大语言模型。该应用无需 PC 辅助,也不依赖互联网连接,仅凭 PS4 内部 2013 年架构的 AMD GPU 和 CPU,即可实现每秒 31 到 43 个 token 的生成速度,并支持语音对话、听写及本地 Python 代码执行。
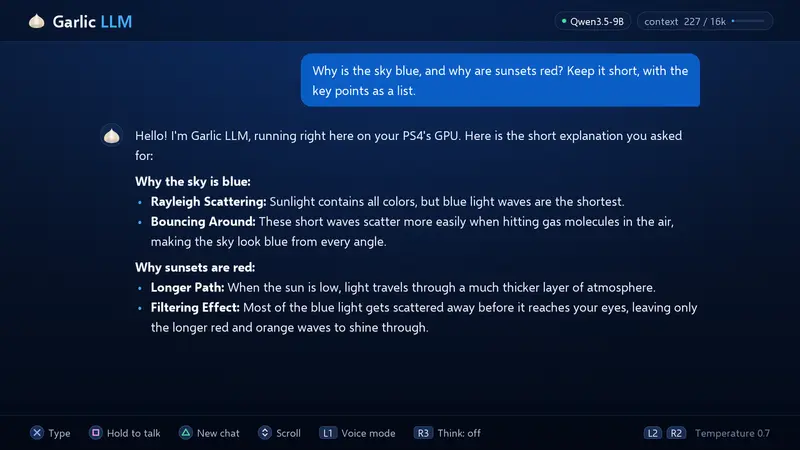
PS4 的自制程序环境并不提供标准的计算 API 或机器学习库。Garlic LLM 通过底层逆向工程,直接与硬件通信:
| 功能 | 详情 |
|---|---|
| 文本聊天 | 基于 Qwen3.5-9B,速度约 31–39 tokens/s,代码生成最高可达 43 tokens/s。支持 16K token 上下文。 |
| 语音交互 | 集成 Chatterbox TTS 模型,支持英、西、葡、俄、意、法、德 7 种语言的语音回复。 |
| 语音听写 | 集成 Parakeet TDT 0.6B v3 模型,支持 25 种欧洲语言的语音转文字。 |
| Python 执行 | 内置 MicroPython 解释器,可运行模型生成的简单 Python 脚本。 |
| 推测解码 | 利用 Qwen3.5 的多 token 预测 (MTP) 头,提前起草最多两个 token,显著提升生成速度。 |
注:在基础版/Slim PS4 (固件 11.52) 上测试。PS4 Pro 用户报告速度在 25–45 tokens/s 之间。
Garlic LLM 还提供了一个可选的 OpenAI 兼容 API。用户可在应用内按 L3 键开启 API 服务,随后局域网内的其他设备即可通过 http://<PS4_IP>:8080/v1 调用主机上的模型。这为开发者提供了一个极低成本的本地推理节点,可用于测试智能体或轻量级应用。
Garlic LLM 证明了即使在十年前的消费级硬件上,通过极致的底层优化和量化技术,也能运行现代中等规模的大语言模型。它不仅是一个技术演示,更是一个完全隐私保护、去中心化的 AI 交互终端。
局限性:
Garlic LLM 的出现,为老旧硬件的再利用和边缘 AI 计算提供了新的思路,也展示了开源社区在突破硬件封锁方面的强大创造力。