Bash4LLM
Bash4LLM⁺ — 安全、Bash优先且完全可审计的封装 CLI,用于 Groq 兼容 OpenAI Chat Completions API(并可扩展至其他提供商)。Bash4LLM⁺ 是一个单一的、自包含的、可读且可验证的 Bash 脚本。下载、赋予执行权限、导出您的 API 密钥,然后立即开始使用。
 Molten
 是一款专为 Apple Silicon 架构定制的原生推理引擎,旨在高效运行 LiquidAI LFM2.5-24B-A2B 模型(240亿参数,20亿激活参数的推理与编码智能体模型)。该引擎将官方提供的 4-bit 量化检查点封装为单一的可执行文件,在保持数学计算精度与官方基准一致的前提下,显著降低了端侧推理的延迟与资源开销。
正确的环境配置是引擎正常运行的前提。请严格按照以下步骤完成安装与初始化。
1. 硬件与系统前置要求
2. 预编译二进制与模型下载
通过终端执行以下命令,下载最新版本的预编译二进制文件及对应的 4-bit 模型权重:
# 下载并解压二进制文件
curl -L https://github.com/zhangshuibai/molten/releases/latest/download/molten-macos-arm64.tar.gz | tar xz
cd molten-macos-arm64

# 下载 LiquidAI 官方 MLX 4-bit 检查点到本地目录
huggingface-cli download LiquidAI/LFM2.5-24B-A2B-MLX-4bit \
  --revision 667408d494bde191c2cb9dd4f4549827816b9275 --local-dir ~/models/lfm2.5
注意:若通过网页浏览器下载了归档文件,macOS 可能会施加下载隔离保护。在运行前,需在终端执行 xattr -d com.apple.quarantine molten 以解除隔离。
3. 源码构建(可选)
若需从源码编译,请确保系统已安装 Rust 1.92 或更高版本。在克隆的仓库根目录下执行:
cargo build --release
编译生成的二进制文件位于 target/release/molten。
4. 基础运行命令
# 启动交互式聊天界面
./molten chat --model ~/models/lfm2.5

# 执行单次推理任务
./molten run --model ~/models/lfm2.5 --prompt "Write a quicksort in Rust."

# 启动 OpenAI 兼容的本地 API 服务器(默认端口 8080)
./molten serve --model ~/models/lfm2.5 --port 8080
5. Python 客户端调用示例
启动服务器后,任何兼容 OpenAI SDK 的客户端均可直接调用:
from openai import OpenAI

# 初始化客户端,指向本地 Molten 服务
client = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="none")

resp = client.chat.completions.create(
    model="lfm2.5",
    messages=[{"role": "user", "content": "What is 17 * 23?"}]
)
print(resp.choices[0].message.content)
注:模型的推理过程内容将通过 reasoning_content 字段返回,工具调用则通过标准的 OpenAI tool_calls 结构返回。采样参数默认遵循模型卡的推荐设置。
Molten 的性能优势源于其“单一模型、单一 GPU、单一序列”的专注设计,这使得它能够执行通用框架无法实现的底层优化。
1. 性能对比数据
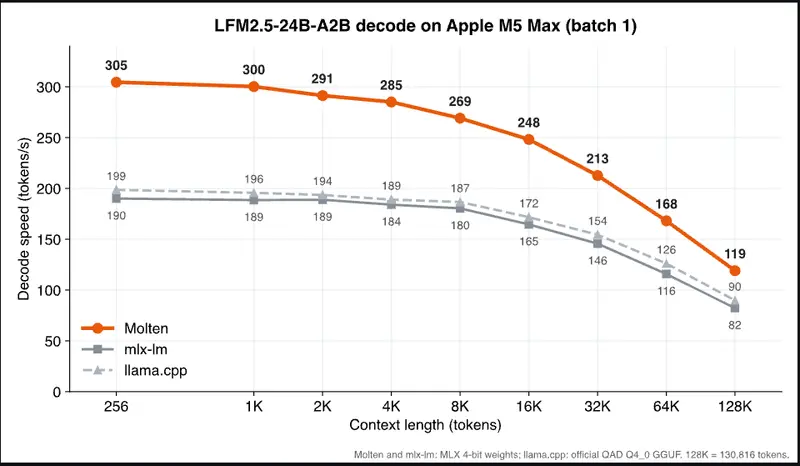
在 Apple M5 Max(128 GB 内存)环境下,处理单序列 128 个解码 token 的测试结果如下(TPS 为每秒解码 token 数,TTFT 为首个 token 生成时间):
| 上下文长度 | TPS (Molten / MLX-LM / llama.cpp) | TTFT (Molten / MLX-LM / llama.cpp) |
|---|---|---|
| 256 | 305 / 190 / 199 | 60 ms / 67 ms / 70 ms |
| 1K | 300 / 189 / 196 | 128 ms / 147 ms / 201 ms |
| 4K | 285 / 184 / 189 | 395 ms / 464 ms / 859 ms |
| 16K | 248 / 165 / 172 | 1.76 s / 2.17 s / 4.20 s |
| 64K | 168 / 116 / 126 | 10.5 s / 12.2 s / 25.2 s |
| 128K | 119 / 82 / 90 | 28.1 s / 32.4 s / 72.7 s |
在端到端测试中(1K token 提示词 + 512 个生成 token),Molten 耗时 1.84 秒,而 mlx-lm 耗时 2.77 秒,llama.cpp 耗时 2.81 秒。
2. 核心架构优化
1. 递归自我改进(RSI)构建循环
Molten 的底层代码由 AI 编码智能体(基于 Pi 智能体框架的 DeepSeek V4.1 Flash)在递归自我改进循环中编写完成。其工作流如下:
整个优化周期耗时不到六天。首个正确引擎在 3 小时内达到 mlx-lm 0.56 倍的速度;第 2.5 天实现反超;第 5.7 天达到端到端 1.28 倍的性能(解码速度 1.53 倍,突破 300+ tok/s)。最后一轮由 Claude 协调并行子智能体,对每个内核进行深度分析与解码路径融合,所有更改均经过逐位验证。整个过程的 API 调用成本约为 21 美元(处理 13.6 亿 token,其中 98.6% 为缓存命中)。
2. 准确性验证
在 LiquidAI 模型卡指定的两个基准测试中(使用温度 0.6,最大输出 32768 token,在 200 个问题的随机子集上运行),Molten 的表现与官方 BF16 精度数据高度一致:
此外,在 1 到 131K token 的公共和留出提示词测试中,引擎均通过了教师强制(Teacher-forcing)一致性检查,贪婪解码生成的 token 除极个别平局情况外完全一致。
在实际工程落地时,需明确 Molten 当前的适用边界:
LiquidAI/LFM2.5-24B-A2B-MLX-4bit(修订版 667408d4)这一特定模型。