9Router
9Router 是一个免费的、智能的 AI 路由器,专为 OpenClaw 生态及各类 CLI 工具设计。它通过智能回退机制,自动将请求路由到免费或廉价的模型,确保你的编程体验永不中断,同时最大化每一分订阅价值。
 Kinference
Buoyant(云原生网络项目 Linkerd 的开发公司)发布了 Kinference v0.1.0-alpha.7。这是一个基于 Rust 编写、采用 Apache 2.0 许可的开源项目,为运行在 Kubernetes 上的 vLLM 环境提供专用的推理控制平面。该项目主要面向需要向大量内部客户交付多种开源权重模型的开发团队,填补了底层模型服务器与上层业务需求之间的调度空白。
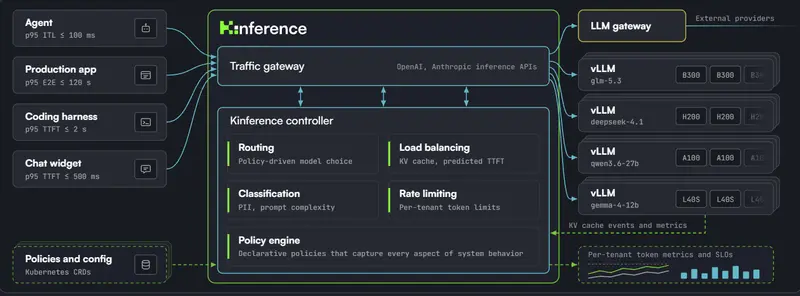
在 Kinference 的设计中,vLLM 承担数据平面的角色,负责实际的模型推理计算;而 Kinference 则作为控制平面,部署在一组 vLLM 工作节点前方,负责决策每个推理请求的最终去向。
系统主要由流量网关和推理处理器两部分构成。推理处理器通过 gRPC 接口接收请求,评估后返回选定的目标端点,并可对请求正文进行必要的变异处理。为了做出精准的路由决策,Kinference 会持续监控 vLLM 的 KV 缓存事件及引擎指标,目前底层依赖 NVIDIA 的 dynamo-kv-router crate 来处理缓存状态。整个系统的配置通过 5 个自定义资源定义(CRD)进行管理:GatewayBackend、InferencePolicy、InferencePool、InferenceProvider 和 InferenceWorkerSet。
Kinference 的核心能力在于其声明性的推理策略(InferencePolicy)。这些策略允许管理员根据租户身份、请求的模型、GPU 池状态或语义标签,制定细粒度的路由或拒绝规则。官方文档展示了五种典型的应用模式:
onEmpty: Reject 直接拒绝请求,确保敏感数据不离开本地环境。standard-model 的稳定路由名称,底层可动态映射至多个不同的具体模型版本,便于平滑升级。大多数策略规则以 minimize: PredictedTTFT(最小化预测的首 Token 时间)为目标。Kinference 会结合缓存重叠率和队列长度,预测每个候选端点的首 Token 延迟。这些策略文件可纳入 Git 版本控制,并支持使用 kinfctl CLI 工具进行离线验证。
Buoyant 公布了一组对比普通 Kubernetes 负载均衡的基准测试数据。测试环境为 3 个运行 vLLM 0.31.0 的 Pod,每个 Pod 分配 1 块 L40S GPU,模型为 Qwen3.8-27B-FP8,负载生成工具为 GuideLLM 0.8.1。基线对照组为 Kubernetes ClusterIP Service,依赖 kube-proxy 进行随机 Pod 路由。
在无负载情况下的中位首 Token 时间(TTFT)表现如下:
在容量测试(Goodput,即满足 TTFT 服务等级目标 SLO 的每分钟有效请求数)中,Kinference 在共享前缀流量下的峰值 Goodput 达到 103.0 req/min,是对照组(14.0 req/min)的约 7.4 倍;在多轮对话场景下为 82.7 req/min,是对照组(23.8 req/min)的约 3.5 倍。Buoyant 指出,即使在无共享前缀的对照流量下,p95 TTFT 也从 21.46 秒降至 12.33 秒,这主要归功于其队列感知的均衡机制。需要注意的是,该测试的 SLO 阈值(8 秒和 4 秒)主要针对离线智能体场景设定,而非实时聊天应用。
在当前的开源推理路由生态中,Kinference 与 llm-d、NVIDIA Dynamo 以及 vLLM Production Stack 形成了差异化竞争:
Kinference 的部署流程包含 5 个标准步骤:安装 Gateway API v1.5.1 CRD、部署 Buoyant Gateway Helm Chart,最后安装 Kinference Chart。系统原生集成了 Prometheus 指标导出与 Grafana 仪表板,可按租户维度监控 TTFT、ITL(Inter-Token Latency)、端到端延迟以及缓存与非缓存提示词的 Token 数量。
目前,Kinference 处于 v0.1.0-alpha.7 阶段。官方明确表示,速率限制、内容分类器以及对 Anthropic API 的原生支持等功能尚未发布,将在后续版本中逐步完善。