
NVIDIA Personal AI Router (PAIR)
NVIDIA Personal AI Router(PAIR)是一个本地推理路由器,适用于同一网络上的一组兼容计算机。它发现参与节点,管理受支持的推理引擎,并向应用和代理提供 Ollama 兼容和 OpenAI 兼容的代理端点。独立请求可根据引擎可用性、模型可用性和当前工作负载路由到符合条件的节点。
 qwenGPU
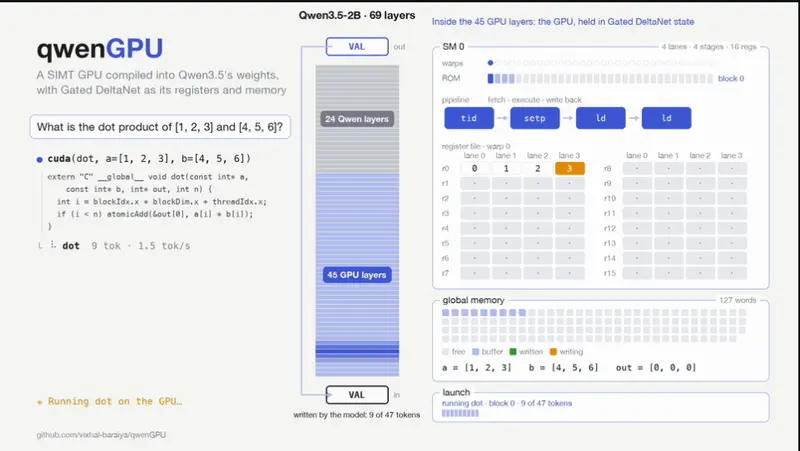
开发者 Vixhal (@TheVixhal) 近期在 GitHub 上以 MIT 许可开源了 qwenGPU,这是一个极具探索性的实验性模型。该项目将 45 个编译的 GPU 层直接嵌入到 Qwen3.5-2B 的权重中,使大语言模型能够在自身的前向传播中直接执行真实的 CUDA 代码,验证了“在预训练 LLM 内部进行精确计算”的可行性。
qwenGPU 在 Qwen3.5-2B 原有的 24 层之前,插入了 45 个未经训练但经过精确编译的 Transformer 层。这些层共同构成了一个 4 通道 SIMT(单指令多线程)机器,具备每通道 15 个寄存器、4 级流水线、32 块 ROM 和 126 个内存字。
其核心技术突破在于对 Gated DeltaNet 循环状态的巧妙利用:
atomicAdd、__syncthreads() 和 warp shuffle 等高级 CUDA 特性。在 qwenGPU 的工作流中,主机(Host)与模型(Model)扮演了明确分离的角色:
EXEC(b, w) token 会在 1 次前向传播中为 warp w 运行块 b。随后的 VAL token 携带寄存器结果,内存写入则作为 MEM 记录返回。尽管引入了复杂的计算图,qwenGPU 在保持模型原有能力方面表现出色:
qwenGPU 是近期“将计算引擎编译入 LLM”趋势的一部分,与同类项目相比各有侧重:
| 特性 | qwenGPU | Qwenputer (RISC-V) | Percepta |
|---|---|---|---|
| 基础模型 | Qwen3.5-2B (24层) | Qwen3.5-4B | 带 2D 注意力头的自定义 Transformer |
| 编译进的机器 | 4 通道 SIMT GPU | 32 位 RISC-V (RV32IM + Zba + bignum) | WebAssembly 解释器 |
| 运行的程序 | CUDA (从 PTX 降级) | C 和 MicroPython | C (编译为 WebAssembly) |
| 状态存储位置 | Gated DeltaNet 状态 | Gated DeltaNet 状态 | 上下文中的执行轨迹 |
| 正确性验证 | 49/49 内核与 Tesla T4 匹配 | 约 230,000 个重放位置 0 不匹配 | 声称数百万可靠步骤 |
由于未发布预构建的检查点,用户需要自行编译模型。运行环境要求如下:
uv、just 构建工具,以及约 16 GB 的空闲内存。clang,以便将 CUDA 编译为 PTX。just build 即可下载 Qwen3.5-2B 并将 GPU 编译进去。最终生成的检查点遵循 Qwen 的 Apache-2.0 许可协议。