
New API
New API 是新一代 AI 基座平台,为您的 AI 应用提供统一的基础设施。承载所有 AI 应用,管理您的数字资产,连接未来的统一接口平台。
 Strata
 是一款免费开源本地大模型运行引擎,能够在普通游戏电脑上部署1250亿参数Qwen3.8-Flash-Next模型,支持对话、代码编写、图像理解,可对接各类应用与编程智能体,所有数据保存在本机,不上传云端。
显卡最低12GB显存,支持英伟达RTX20/30/40/50系列,AMD RX 7000、9000系列;推荐内存32GB起步,64GB内存可完整加载全部模型规格,预留80GB以上SSD空间。Windows 10/11、Linux双平台可用,还支持多卡分担模型负载。
社区实验性兼容老显卡、Intel Arc(Linux源码编译),无AVX2指令集老旧CPU虽然能跑,但推理速度会明显下降。
在主流游戏主机实测,Q2_0规格下RTX5070(12GB)生成速度可达94 token/s,读取32K长提示词最高2650 token/s;RX9070 XT(16GB)Q2_0生成速度60 token/s,读提示1160 token/s。显存越大性能越强,24GB的RTX3090最高可做到100–140 token/s。
内置多种量化规格,Q2_0、IQ2_XS速度更快;IQ3_S综合能力最强,推理速度相对慢一些。还有Coder专用编程版本,32GB内存就能运行,代码能力达到完整模型91%,但中文等多语言能力有所削弱。
把仓库链接指令交给Claude Code、Cursor等编程Agent,自动检测本机硬件,匹配适配模型,完成下载、启动,还能通过MCP服务器启停管理Strata。
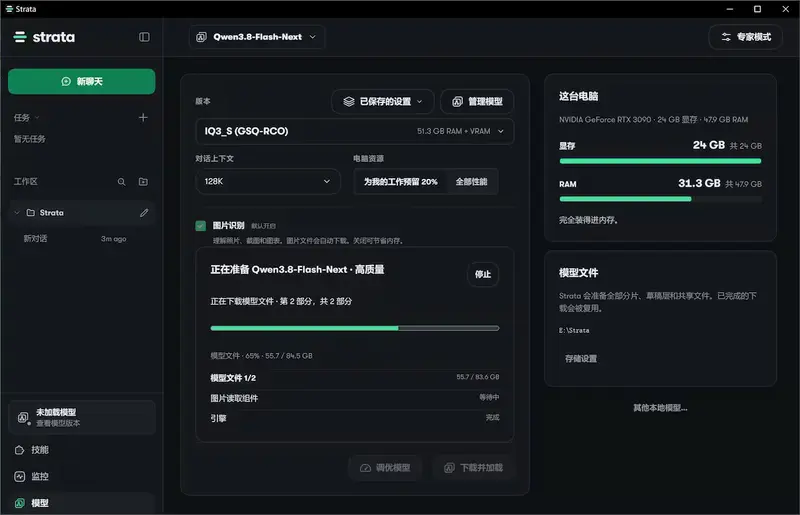
Windows双击START-HERE.bat,Linux执行./setup.sh,脚本自动识别显卡并部署对应引擎。按需选择模型、上下文窗口,开启图像识别功能。模型包约70GB,下载中断支持断点续传,完成后本地访问[http://127.0.0.1:8080](http://127.0.0.1:8080)网页端。
首次加载模型耗时1–3分钟,会占用35–55GB内存,电脑短暂卡顿属于正常现象。
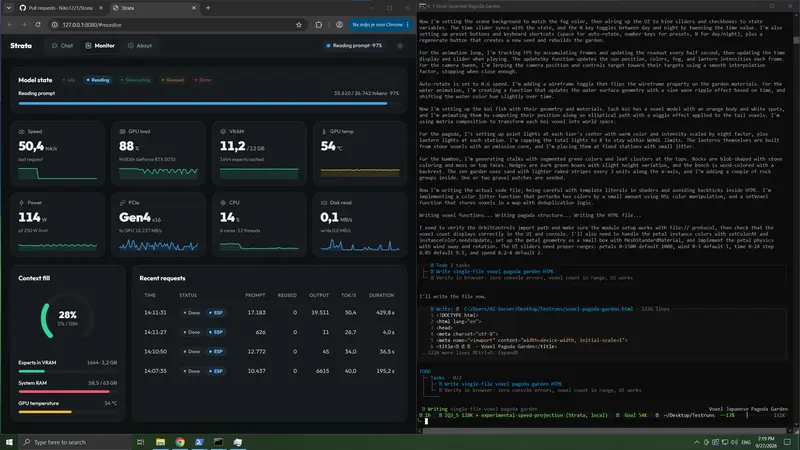
自带网页控制台,包含聊天界面、硬件与模型监控面板。
API层面兼容OpenAI协议,应用填写http://127.0.0.1:8080/v1即可接入;也适配Anthropic接口、OpenAI Responses API,可直接对接Claude Code等工具。
支持图片输入,AMD显卡Windows环境暂不支持识图;支持调节推理思考强度,支持局域网其他设备访问(需手动配置密钥),默认单请求排队,可开启并行多请求。
Qwen3.8-Flash-Next属于MoE混合专家模型,一共24576个专家,生成每个token仅激活其中10个。Strata把高频专家放在GPU显存,全部专家存入系统内存,SSD存储索引表,将计算分摊到显卡、内存、CPU。同时采用预猜测校验机制,在不降低输出质量前提下,提速1.6~1.8倍,长文本分块读取,大幅提升长提示词处理速度。
Strata于10月19日和20日连续发布了 0.2.0 测试版及 0.2.1.1 更新,核心目标是进一步降低本地大模型的运行门槛。此次更新不仅将内存与显存的合计最低需求压低至 27.6GB,还正式引入了独立的图形用户界面(GUI),覆盖 Windows、macOS 和 Linux 平台,用户无需再通过命令行进行编译部署。
推理性能实测数据
底层推理引擎经过针对性优化,不同硬件平台均有明确的速度提升:
- NVIDIA:RTX 30 系列显卡的文本生成速度最高提升约 13%(RTX 3060 实测提升 10.2%,RTX A4000 提升 13%)。
- AMD:RX 9000 系列显卡在处理部分模型的提示词时,速度接近翻倍。
- Intel:Arc 显卡获得加速,A750 的提示词处理速度提升约 42%。
核心功能与新特性
- 可视化任务板:应用内新增任务视图,通过“计划/板”开关,可将任务状态直观展示为看板。运行中、等待批准或失败的任务会分行显示,侧边栏会提示需要人工介入的任务数量,且支持八种界面语言。
- 多端图片读取优化:Mac 应用和 Terminal 现已默认支持 GPU (Metal) 图片读取。在 M4 Mac 上,260 token 的图片读取时间从 CPU 的 50.7 秒缩短至 GPU 的 0.45 秒。Intel Arc A 系列(Alchemist)默认使用 CPU 读取器,而 B 系列(Battlemage)可选 GPU 读取,A750 上单张图片处理时间从 1.73 秒降至 0.16 秒。
- 下载加速与 Docker 支持:大模型文件下载现采用 16 个并发连接,实测下载速度提升约 9%,草稿层(MTP)文件列表获取时间从 28 秒缩短至 4.6 秒。同时,官方提供了现成的 Docker 镜像(涵盖 cuda13/12 及多种 ROCm 架构),由工作流自动从签名发布包构建。
- 标准基准测试:新增
strata bench run命令,内置 standard-v1 固定请求套件、评分器与验证器,用于生成不含个人数据的标准化测试报告。底层机制调整与新默认值
- 用户配置保留:过去应用在每次加载时会重写运行配置。现在,用户手动设置的选项(如
--vram-reserve-mib或控制向量)会保存在user_args中,优先级高于应用自动生成的配置。- 草稿层(MTP)独立开关:设置中新增了按模型开启或关闭 MTP 的选项。开启时,MTP 约占 1GB 显存,模型适配检查和专家缓存大小现已计入该显存占用。
- 硬件专属调优:针对带 Radeon 780M 的 Linux 迷你 PC,默认开启了矩阵核心提示集,1K 提示词处理速度提升 1.6 倍。针对 Strix Halo (gfx1151),默认启用了 hipBLASLt 调优表,提示词处理速度提升约 2.11 倍。
部署选择与关键修复
官方提供了针对不同系统和显卡的细分安装包。例如,Windows 用户需根据 NVIDIA 驱动版本(580 及以上或以下)或 AMD 显卡代数(RX 9000 系列或 RX 7000 系列)选择对应的
.exe文件。在最新的 0.2.1.1 更新中,重点修复了 Windows Terminal 的安装问题。在默认关闭长路径支持的 Windows 系统上,旧版安装 AMD 引擎会因路径过长导致
FileNotFoundError。新版已将引擎解包至更短的文件夹路径,确保strata launch命令正常工作。现有用户可通过 PowerShell 运行官方安装脚本进行覆盖更新,原有的模型和设置将被完整保留。