OpenClaw 极简安全实践指南
OpenClaw 极简安全实践指南 (Security Practice Guide)是专为 高权限自主智能体 (OpenClaw) 量身定制的权威安全实践指南。它将传统“主机静态防御”的范式转变为“智能体零信任架构 (Zero-Trust Architecture)”,有效应对破坏性操作、提示词注入、供应链投毒和高危业务逻辑执行等智能体专属风险。
 NVIDIA Run:ai
英伟达近日宣布,将完整的 NVIDIA Run:ai 平台作为开源软件发布。源代码已在 GitHub 上以 Apache 2.0 许可证公开。这一举措意味着生产环境中的 GPU 调度、配额分配和工作负载管理权正式交到了开发者手中。平台团队现在可以直接检查、fork 并自托管该技术栈,无需购买付费订阅。
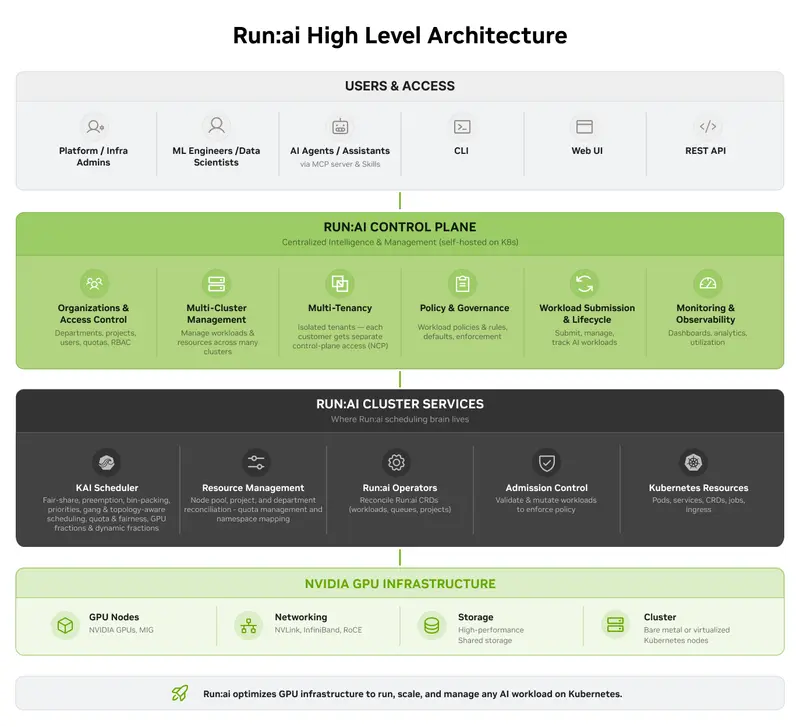
NVIDIA Run:ai 是专为 Kubernetes 设计的 AI 工作负载和 GPU 编排平台。它运行在 Kubernetes 之上,作为现有架构的增强,主要用于在共享 GPU 集群中调度开发、训练和推理任务。
整个开源版本是一个单体仓库(monorepo),包含控制平面、集群服务、安装程序、CLI 以及用于 AI 助手的 MCP 服务器。本地开发构建涉及约 50 个 Go 服务。用户可通过 Web UI、命令行、REST API 等多种方式与系统交互。
英伟达将此次发布拆分为四个可独立采用的组件:
为了方便开发者测试,英伟达提供了基于 local-dev.sh 脚本的本地开发指南。该脚本会在容器内从源码构建服务,并创建一个固定在 Kubernetes v1.32.5 的 5 节点 Kind 集群。内置的假 GPU operator 会模拟 8 个 Tesla-A10 GPU,因此本地测试无需真实的 GPU 硬件。
本地运行支持 macOS 或 Linux(amd64 或 arm64),不支持 Windows。Linux 主机至少需要 4 个 CPU 核心、16 GB 内存和 100 GB 可用磁盘;macOS Podman VM 则需至少 12 GB 内存。完整构建后会产生约 44 GB 的缓存。
如果需要使用真实硬件,可通过 --gpu-operator 标志切换。但这要求 Linux 环境、Docker 以及 NVIDIA Container Toolkit,且不支持 AMD 或英特尔加速器。
在生产环境中,团队可以从源码或 NGC Community Product Helm chart 进行部署。该版本无需付费订阅,但也不包含英伟达的企业级技术支持。此外,团队还可以通过 Crusoe、Mirantis、Nebius 等 8 个 DSX 生态系统合作伙伴来采用该技术。需要商业支持的版本仍可通过 NVIDIA AI Enterprise 等渠道获取。
随同发布的还有两个相邻的开源项目,进一步完善了技术栈:
--load-format runai_streamer 即可使用。微软的基准测试显示,在 8 个英伟达 H100 VM 上,其模型加载速度比默认加载器快 3 到 6 倍,吞吐量保持在 80 Gbps,而默认路径约为 40 Gbps。与 Volcano、Kueue 或 Apache YuniKorn 等专注于单一调度或排队功能的开源项目不同,NVIDIA Run:ai 的核心区别在于其“完整平台”的定位。它不仅提供了底层的 KAI 调度器,还在此基础上构建了包含控制平面、Web UI、CLI 和 REST API 在内的全套管理工具。同时,它利用 CUDA 13.4 实现了带硬内存限制的 GPU 共享,并在拓扑感知和多集群管理方面提供了开箱即用的支持。
对于希望在内部集群中实现精细化 GPU 资源管理的团队而言,这次开源提供了一个无需额外许可费用的成熟基座。