Models.dev
Models.dev 不只是一个数据库,更是 AI 开发者生态中不可或缺的基础设施。它的目标是让 AI 模型的选择更透明、使用更便捷。无论你是想快速找到最适合项目的模型,还是希望为开源社区贡献力量,Models.dev 都值得你关注和参与。
 Jev + Kimi K3 欺诈检测
Nutlope 发布了一个开源欺诈检测演示,展示如何将 Jev 语义决策引擎与 Kimi K3 大模型组合为分层分类管线。Jev 对 100 封真实邮件(50 欺诈/50 合法)进行初筛并返回置信度分数,≥95% 的预测直接采纳,低于阈值者交由 Kimi K3 独立复审。在记录的运行中,该管线正确分类 92/100 封邮件,总耗时 6.1 秒,估算成本约 $0.102。
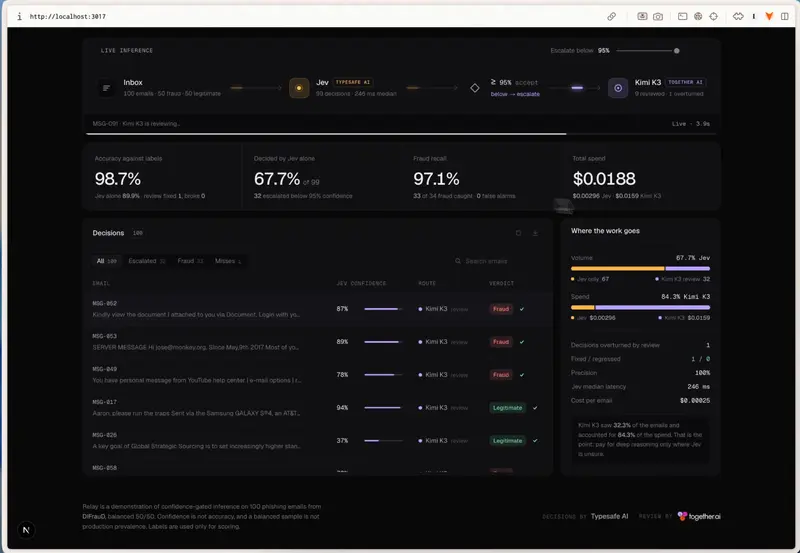
该演示核心价值在于验证置信度驱动的路由策略:用低成本、低延迟的专用决策模型处理高确信样本,仅将模糊案例交给昂贵通用模型,从而在准确率与成本间取得平衡。代码完全开源,支持本地回放、实时运行及 Vercel 部署。
关键设计原则:两个模型均看到原始邮件,避免级联误差;置信度阈值可调,便于探索不同精度-召回权衡;录制模式保存完整结果至 data/recording.json,支持离线分析。
记录运行指标:
重要注意事项:
该演示是概念验证而非生产系统。其价值在于提供可复现的基准,帮助团队评估分层路由策略的可行性,而非承诺特定性能。
本地运行:
git clone https://github.com/Nutlope/jev-fraud.git
cd jev-fraud && npm install
cp .env.example .env.local
# 编辑 .env.local 填入 TOGETHER_API_KEY 和 AI_GATEWAY_API_KEY
npm run dev -- --port 3017
访问 localhost:3017。无密钥时可使用 10s replay 模式观看预录结果。
录制新运行:
npm run benchmark # 执行付费 API 调用,保存至 data/recording.json
⚠️ 先完成当前实时运行再录制,避免数据冲突。
Vercel 部署:
TOGETHER_API_KEY 和 AI_GATEWAY_API_KEY 为环境变量npm run buildENABLE_LIVE_RUNS=true 并配置 Deployment Protection 或身份验证默认部署仅启用重放模式,防止意外产生费用。生产使用前务必添加访问控制。
此演示适用于以下场景:
不适用场景:
建议在生产前:扩大测试集规模、验证置信度校准、监控实际账单、建立回退机制。此演示是起点,而非终点。