Chrome DevTools MCP
chrome-devtools-mcp 让你的编码代理(如 Gemini、Claude、Cursor 或 Copilot)控制并检查实时 Chrome 浏览器。它充当 Model-Context-Protocol (MCP) 服务器,让你的 AI 编码助手访问 Chrome DevTools 的全部功能,用于可靠的自动化、深入调试和性能分析。
EvoOntology 可以理解为数据分析 AI 助手专属的**业务词典**。企业数据库、表格里大多只有字段代号与原始数值,AI 很难理解背后真实业务含义,分析时容易误判,反复试错。EvoOntology 负责梳理业务规则,构建结构化语义知识库,并且可以观测 Agent 执行过程,自动补充、修正这套词典,越使用越贴合业务。
 EvoOntology
在企业数据分析场景中,AI Agent 常常面临一个核心痛点:原始数据只有代号和数字,缺乏显式的业务语义。这导致 Agent 在分析时频繁猜测、重复探索,甚至产生严重的语义错误。EvoOntology 正是为解决这一 “Agent-Data Gap” 而生的开源项目。
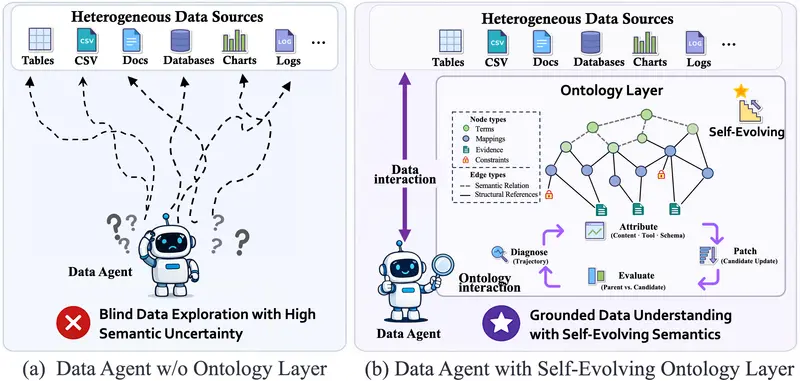
它不仅仅是一个静态的知识库,更是一个可训练、自进化的 Ontology Layer。通过 MCP 工具集成,它能根据真实的 workload 和执行轨迹持续自我修正,让 Data Agent 越用越聪明。
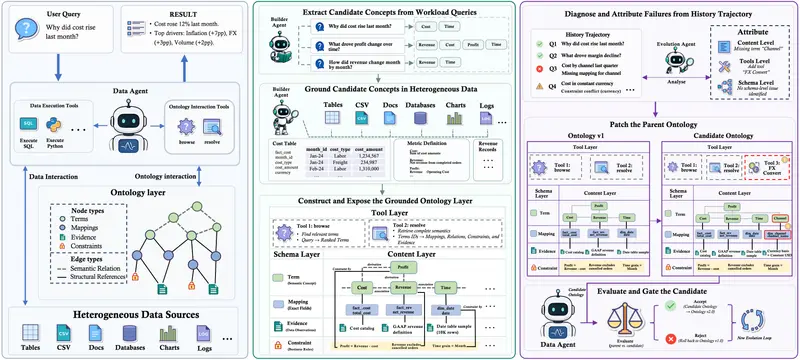
EvoOntology 将 Ontology Layer 视为一种可训练的 Agent 状态,由三个相互关联的层组成:
| 层级 | 作用 | 关键特性 |
|---|---|---|
| Content Layer | 类型化语义图 | 包含 Term、Mapping、Constraint、Evidence 四类节点及其关系 |
| Schema Layer | 表达边界定义 | 规定节点字段、合法关系类型及结构引用模式 |
| Tool Layer | 运行时访问接口 | 通过 browse_semantics / resolve_semantics 按需暴露语义,会话初始化仅注入轻量 manifest |
ontology_v0。EvoOntology 已上架 GitHub Marketplace,支持 Claude Code 和 Codex 等主流 Agent 框架,无需手动 clone 或配置环境。
claude plugin marketplace add MeiduoChong/EvoOntology
claude plugin install evoontology@evoontology
# 新建会话后运行
/evo-build      # 构建初始本体
/evo-evolve     # 触发自进化
/evo-visualize  # 可视化语义图
codex plugin marketplace add MeiduoChong/EvoOntology
codex plugin add evoontology-codex@evoontology
# 新建 thread 后使用
$evo-build
$evo-evolve
$evo-visualize
构建完成后,Data Agent 即可直接调用 MCP 工具查询语义,无需额外配置。
在四个主流分析 Benchmark 上,EvoOntology 相比无 Ontology Layer 的 ReAct 基线均取得明显提升:
| Benchmark | 指标 | ReAct (无本体) | 初始本体 | EvoOntology | 相对提升 |
|---|---|---|---|---|---|
| DDR-Bench (10-K) | Trajectory-Wise | 69.5 | 81.8 | 89.5 | +20.0 |
| BIRD | Execution Accuracy | 63.6 | 68.7 | 72.4 | +8.8 |
| InsightBench | Insight Score | 53.2 | 54.0 | 54.2 | +1.0 |
💡 关键洞察:初始本体已带来显著收益,而自进化机制能在此基础上进一步持续提升,证明“基于真实 workload 的定向进化”策略有效。
两种模式共用同一套 .evoontology/ workspace 和版本管理体系,无缝切换。