AutoTTS
Meta、谷歌及多所高校的研究人员共同推出了 AutoTTS,一个能够自动发现最优测试时扩展策略的框架。通过自动化搜索,AutoTTS 在不牺牲准确率的前提下,将 Token 消耗量降低了高达 69.5%,为大规模部署高级推理模型提供了极具吸引力的成本优化方案。
加州大学伯克利分校研究团队推出 CUA‑Lite,面向计算机使用代理(CUA)的开源研究平台。项目跳出 “以模型为中心” 的思路,聚焦基础设施层面的痛点:训练、评测计算机使用代理,需要代理、运行环境、交互轨迹、训练评估框架四大组件,但现有资源分散在互不兼容的独立仓库。CUA‑Lite 将它们整合,提供统一操作空间、统一数据格式与统一调用接...
 CUA-Lite
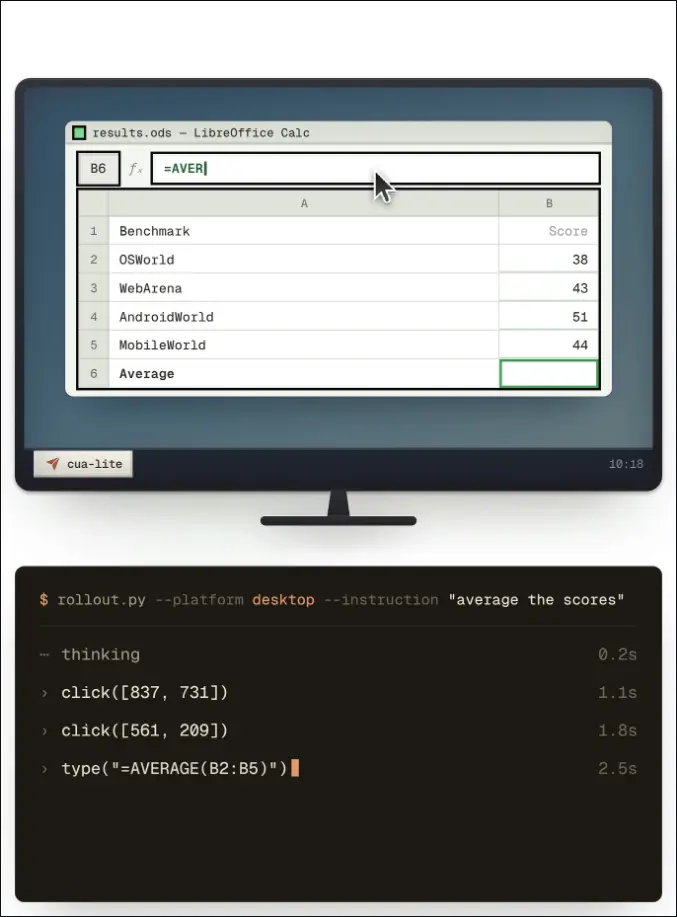
加州大学伯克利分校的研究团队正式发布了 CUA-Lite,这是一个解决计算机使用代理(Computer Use Agents, CUA)研究碎片化问题的开源平台。CUA-Lite 的核心贡献在于基础设施层面的统一:它将分散在独立仓库中的代理、环境、轨迹数据和评估框架整合到一个兼容的操作空间、数据模式和命令接口下,覆盖了桌面、浏览器和移动端三大场景。
CUA-Lite 最具影响力的创新是 Lite.OSWorld。传统的 OSWorld 基准测试依赖于完整的 QEMU/KVM 虚拟机来模拟 Ubuntu 桌面,这需要嵌套虚拟化支持,导致部署成本高、并行度低。
CUA-Lite 通过将其重构为基于 Docker 容器 的 GNOME 桌面环境,彻底改变了这一现状:
| 特性 | 传统 OSWorld (VM) | Lite.OSWorld (Container) |
|---|---|---|
| 运行时 | QEMU/KVM 虚拟机 | Docker 容器 |
| 主机要求 | 需 /dev/kvm 及嵌套虚拟化 | 任何 Docker 主机(含云实例/CI) |
| 内存占用 | 4.1 GB | 0.9 GB |
| 冷启动时间 | 29.9 秒 | 23.8 秒 |
| 并行能力 | 基线 | 约 4.6 倍实例数 |
| 任务保真度 | 高 | 与 VM 匹配(13个模型验证) |
关键结论:在 13 个主流模型上的测试表明,Lite.OSWorld 的得分与原版 OSWorld 高度一致。这意味着在轻量级容器中获得的训练信号和评估结果可以直接迁移到真实基准测试中,极大地降低了研究和大规模评估的门槛。
为了消除不同数据集之间的格式壁垒,CUA-Lite 引入了 LiteSample,一种跨所有环境、代理和任务类型的统一监督学习数据模式(Parquet + 图像)。
CUA-Lite 通过 lite.gym 接口实现了代理与环境的无缝对接,支持“一条命令”完成评估、监督微调(SFT)和强化学习(RL):
scripts/rollout.py 中切换 --model-id 和 --env-id 即可运行。lite.osworld 评估集上将平均回合回报从 0.138 提升至 0.237。uv sync --all-extras 安装。