Code Wiki
谷歌正式发布了 Code Wiki,这是一个为代码仓库提供持续更新、结构化 Wiki 的全新平台。平台利用 Gemini 生成文档,随着代码演进,文档内容会自动刷新。每一次代码变更后,Code Wiki 都会自动扫描仓库并重新生成全部文档,确保 Wiki 内容始终与最新代码保持高度同步。
Cursor Research 开源了 Mixture-of-Kittens(MoK),这是其 Composer 模型背后的混合专家(MoE)训练 Megakernel。该内核将 MoE 的所有通信与计算步骤融合为单一确定性内核,在数万块 GPU 规模的 Composer 训练中得到验证。
 Mixture-of-Kittens (MoK)
Cursor Research 开源了 Mixture-of-Kittens(MoK),这是其 Composer 模型背后的混合专家(MoE)训练 Megakernel。该内核将 MoE 的所有通信与计算步骤融合为单一确定性内核,在数万块 GPU 规模的 Composer 训练中得到验证。测试数据显示,其吞吐量较当前最强公开基线提升 2.37 倍。项目采用 Apache-2.0 许可证发布,但对硬件与软件环境有明确要求,适用场景集中于特定规模的前沿模型训练。
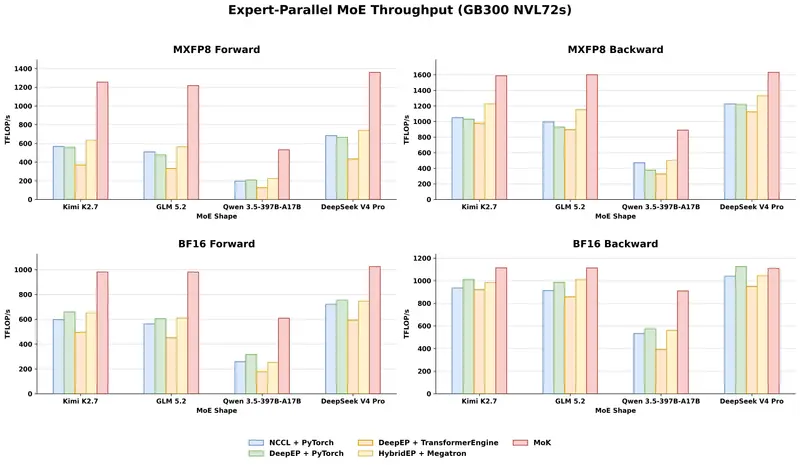
MoK 并非通用型工具,其部署条件将使用者限定在拥有或租赁 NVL72 机架级算力的机构范围内。
符合条件的组织包括前沿 AI 实验室、具备资金的模型初创公司、GPU 云服务商和国家计算中心。核心价值体现在 DeepSeek-V3 风格 MoE 模型的预训练与后训练阶段。由于内核具备完全确定性,在策略内强化学习后训练及内部消融实验中同样具有不可替代的作用。相关行业覆盖 AI 模型开发、云端 GPU 基础设施、代码生成工具及量化研究领域。
Cursor 团队此前已自研 MXFP8、NVFP4 训练内核及用于推理的 Warp Decode 路径,但这些工作均假设 GPU 间通信独立处理。在生产环境中,MoE 层的通信开销可占据端到端训练时间的 50% 以上,成为实际瓶颈。
迁移至 GB300 NVL72 机架后,问题形态发生变化。72 块 GPU 处于同一 NVLink 域内,理论上支持细粒度计算通信重叠;但集成的 Grace CPU 相对 GPU 速度较慢,频繁的 CPU-GPU 同步会抵消 NVLink 带宽优势。MoK 的设计核心即围绕减少此类同步、充分利用机架内互联带宽展开。
MoK 的性能增益来自三个经过微基准验证的工程选择,而非简单的算法替换。
拉取调度替代推送以降低信号延迟
现有方案如 DeepEP 多采用基于推送的传输方式。Cursor 的微基准测试表明,推送模式下单方向移动字节数较少,反向 NVLink 通道大量闲置。MoK 在前向传播中采用“拉取调度 + 推送组合”策略,反向传播则镜像使用“拉取组合 + 推送调度”。实测数据显示:
重叠粒度取中间值以匹配 SM Wave
Comet 代表细粒度重叠,DeepEP 代表粗粒度重叠。Cursor 团队通过实验确定最佳粒度介于两者之间,且与工作负载相关。启发式目标设定为每个专家分组 GEMM 至少覆盖两个完整 SM Wave。以 Kimi 2.5(Composer 2.5 基础模型)维度为例,token 数量下限为 2,368,实测延迟与该估算高度吻合。
环形 Token 缓冲区消除 CPU 介入
传统方案要么丢弃超出缓冲区的 Token,要么由 CPU 动态调整缓冲区大小。MoK 采用固定大小的环形缓冲区(数百 MB),在微批次粒度上循环复用,并在宏批次边界交错执行调度与组合操作。反向传播时,缓冲区反向遍历以避免前向激活重放。该设计实现了零 Token 丢弃,并彻底移除了 CPU-GPU 同步点。
MoK 作为 Megakernel 构建,支持 BF16 与 MXFP8 精度,调度通过 Blackwell Cluster Launch Control 执行,确保机架间 RDMA 不会被序列化。路由器权重梯度采用 SonicMoE 风格计算,融合进 SwiGLU 反向传播。
层级基准在单台 NVL72 机架、EP Degree 64 配置下运行,每 GPU 路由前持有 2,048 Token。对比基线包括 NCCL+PyTorch、DeepEP+PyTorch、DeepEP+TransformerEngine 及 HybridEP+Megatron,测试形状覆盖 Kimi K2.7 Code、GLM-5.2、Qwen3.5-397B-A17B 和 DeepSeek-V4-Pro。
端到端测试在多机架 GB300 NVL72、512 块 GPU 规模下进行,每 GPU 每秒处理 Token 数从 760.9 提升至 1,070.2,整体增益 1.41 倍。