PixelSmile
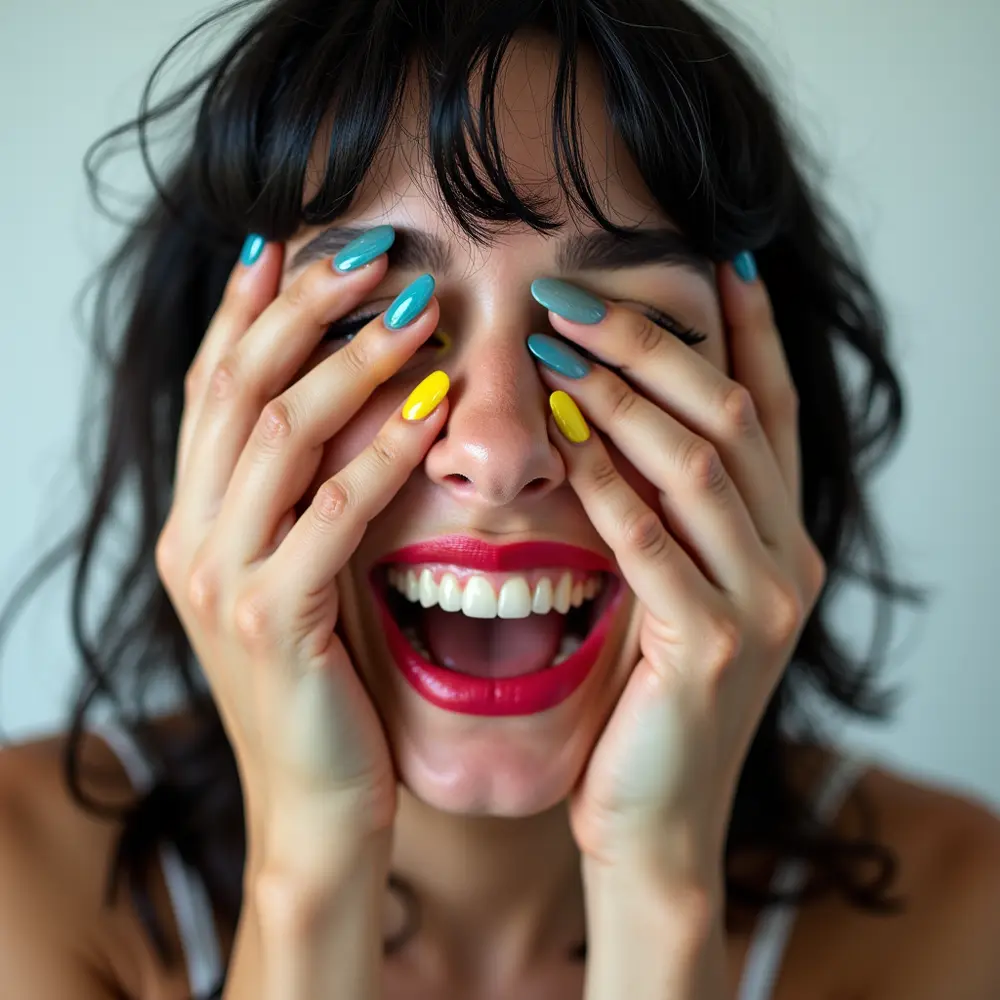
PixelSmile是一款专门针对细粒度面部表情编辑而训练的模型。你可以通过平滑的强度滑块控制 12 种表情,混合多种情绪,并且它同时适用于真实照片和动漫图像。
DMD2 蒸馏 LoRA 给 Qwen-Image-2.1 做两步加速,仅注意力层微调;在大幅减少采样步数的前提下,文生图和图像编辑效果贴近原版 20 步模型,主打交互式实时绘图。
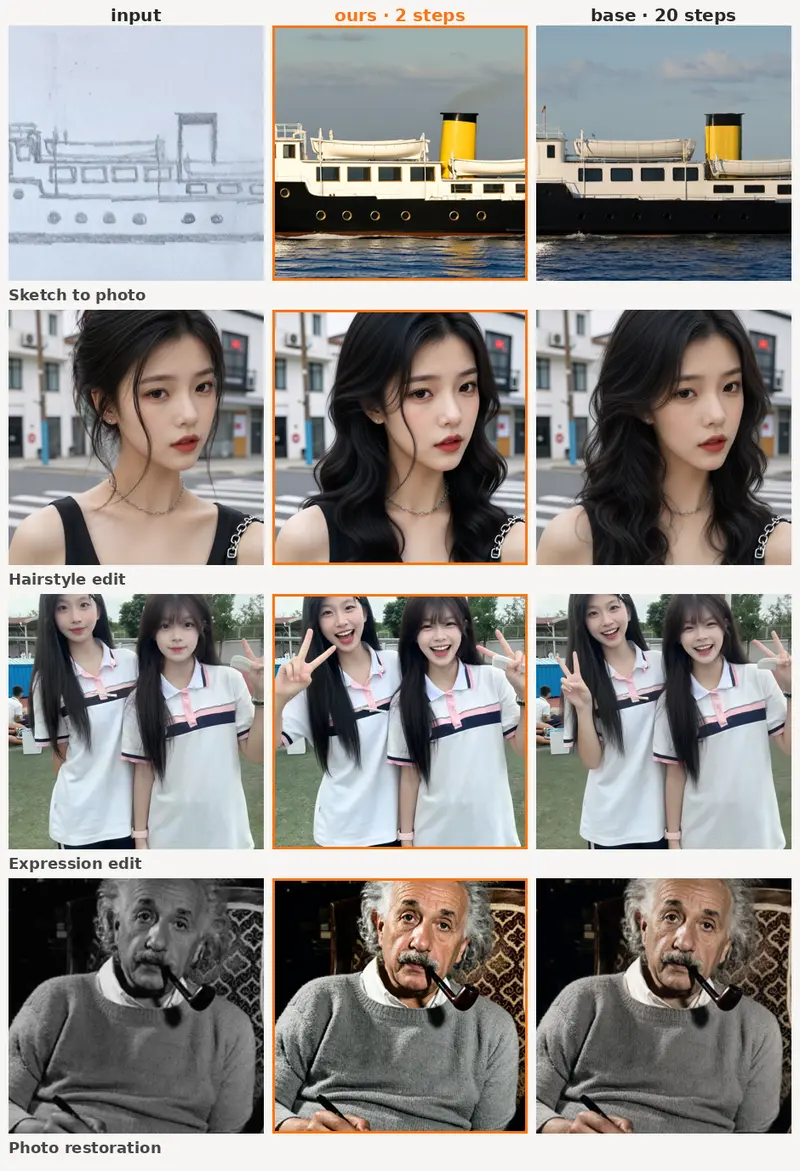
开发者linoyts发布了一款专为 Qwen-Image-2.1 设计的 2 步蒸馏 LoRA 权重。该方案利用 DMD2(分布匹配蒸馏,Distribution Matching Distillation 2)技术,成功将基础模型的 20 步采样过程压缩至仅需 2 次前向传递,同时保持了与全步教师模型高度一致的指令编辑和文本到图像生成质量,为实时和交互式图像生成管道提供了高效的解决方案。
该 LoRA 采用先进的 DMD2 方法进行训练。与传统的蒸馏方法不同,DMD2 采用同策略(on-policy)分布匹配,摒弃了容易产生伪影的回归损失或 GAN 损失。通过引入教师模型的 CFG(Classifier-Free Guidance)指导,该模型能够在极少的采样步数下,精准逼近教师模型的高质量数据分布,从而在保证图像细节和文本对齐度的同时,实现推理速度的数量级提升。
为了在压缩推理步数的同时最大化保留模型的生成能力,该 LoRA 进行了精细的参数设计:
to_q、to_k、to_v 和 to_out.0,有效控制了参数量并防止过拟合。在实际推理阶段,该 LoRA 需要配合特定的参数设置以达到最佳效果:
[1.0, 0.5]。true_cfg_scale 设置为 1.0。在性能验证方面,官方对比测试涵盖了多种复杂的指令编辑任务,包括草图到照片的转换、发型与表情修改以及照片修复。测试结果表明,在相同的输入、提示词和随机种子条件下,该 LoRA 在 2 步下生成的图像(中间列),在视觉质量和指令遵循度上,与基础模型在 20 步下生成的结果(右列)高度接近,未见明显的质量衰减。