Qwen-Image-2.1-viggle-turbo
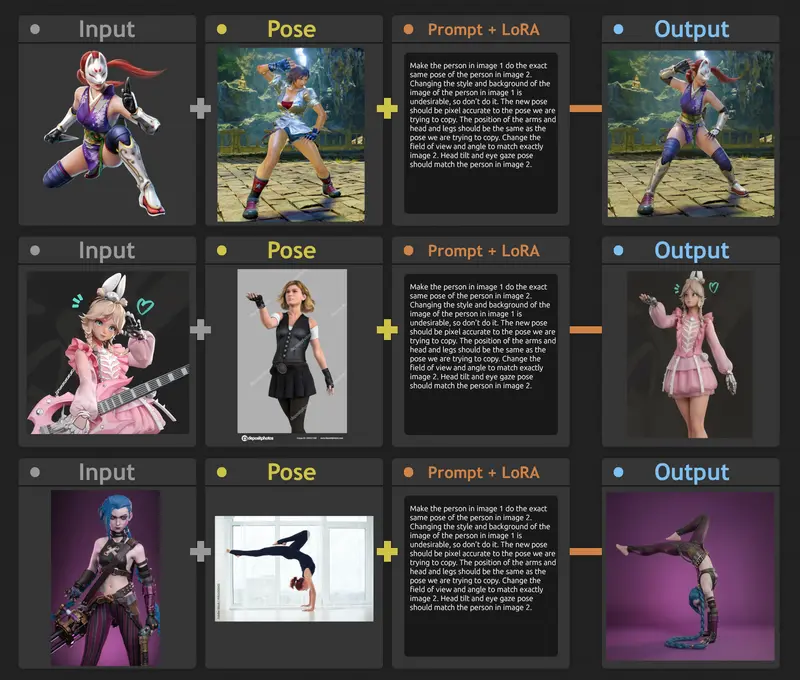
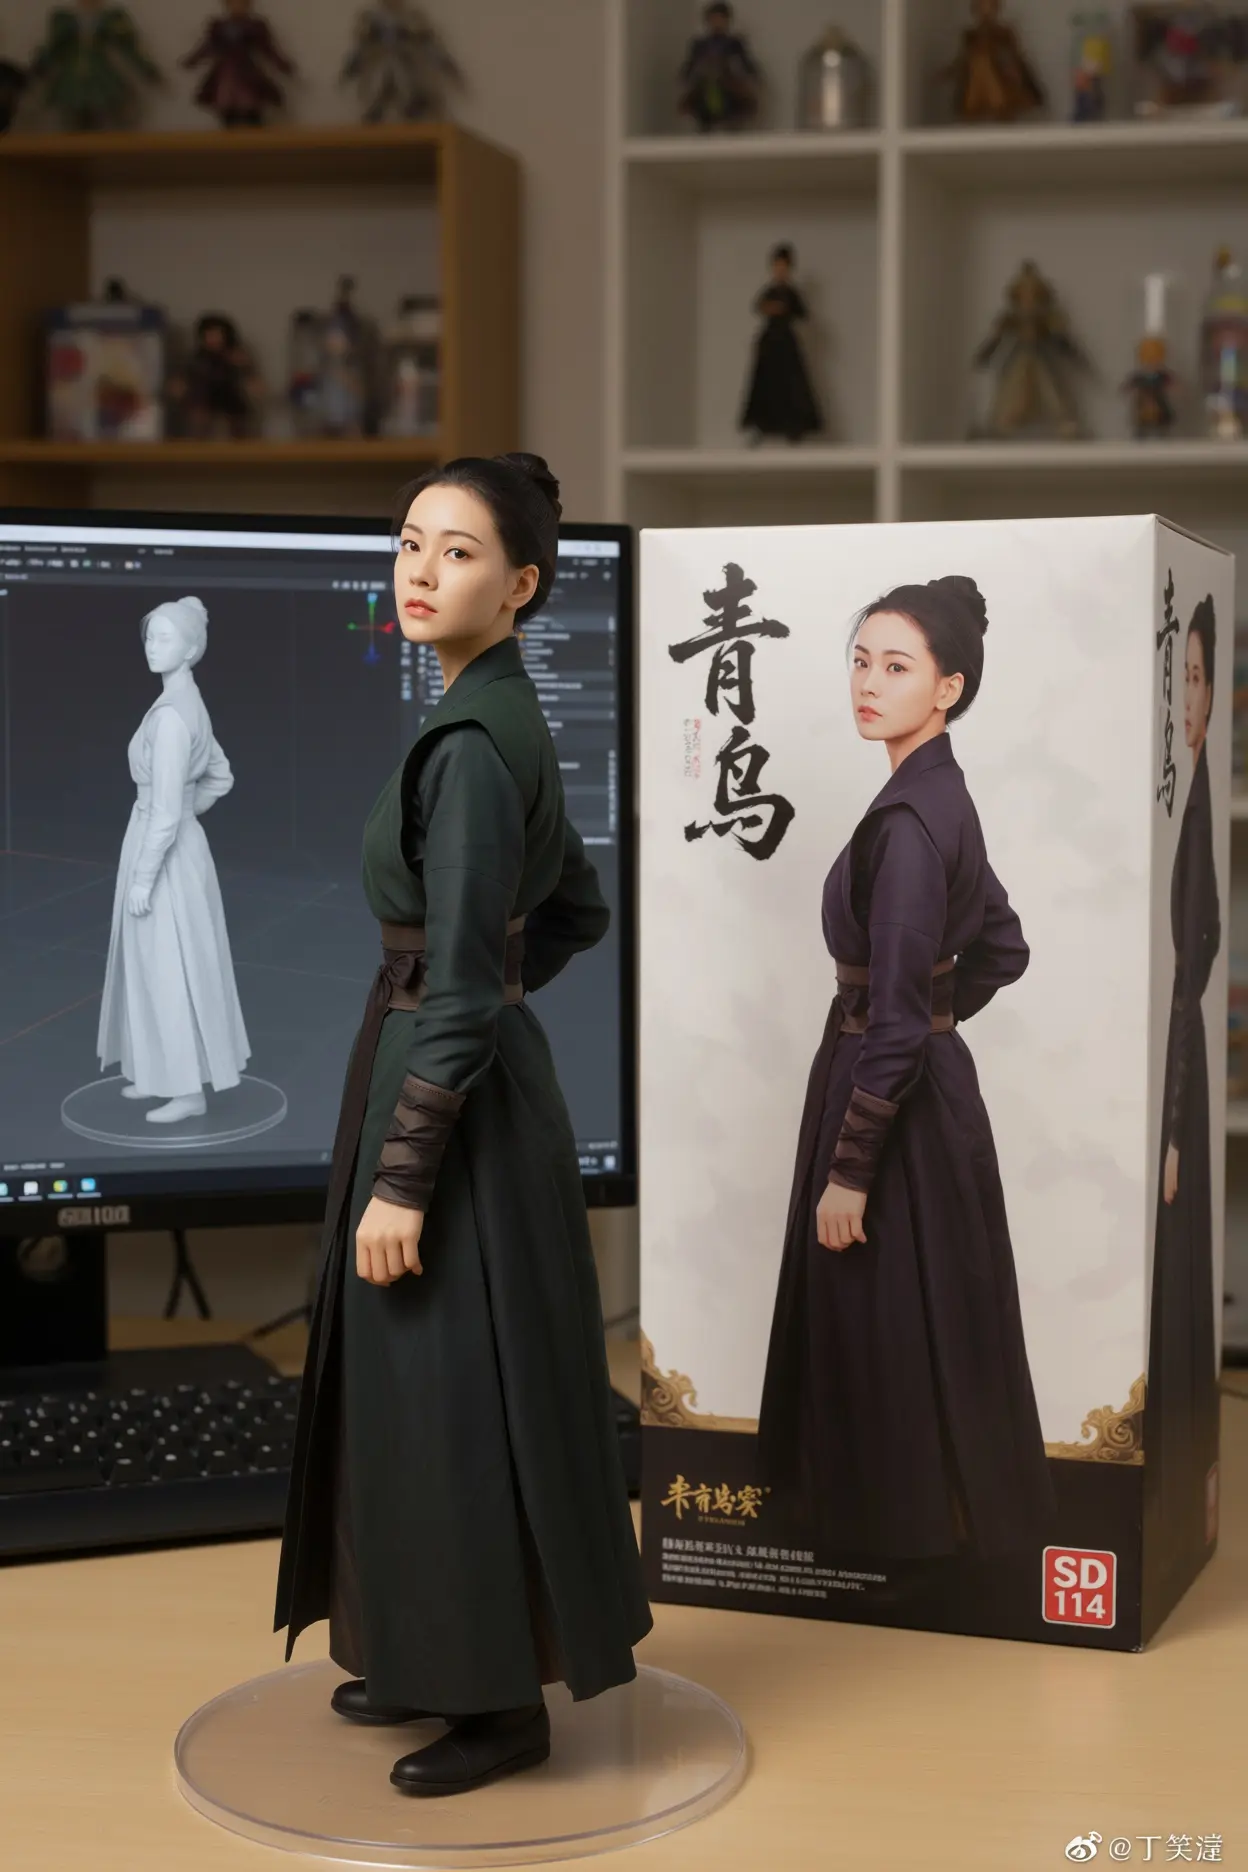
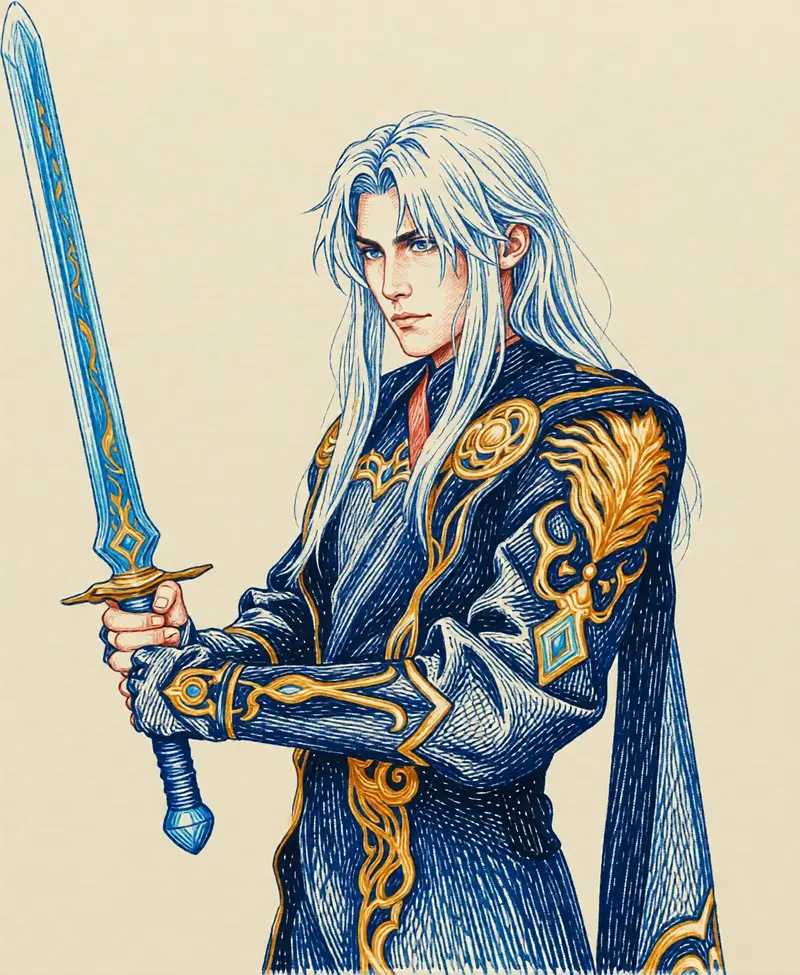
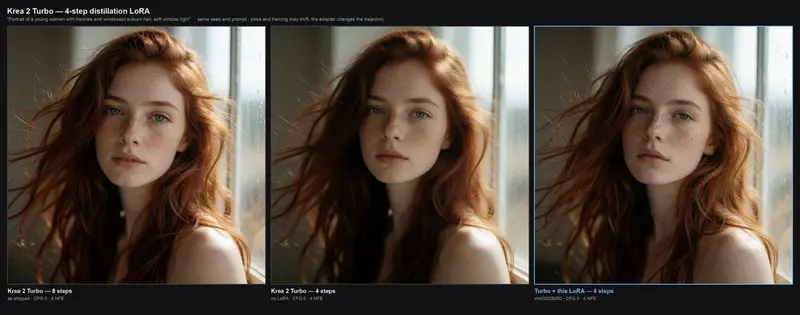
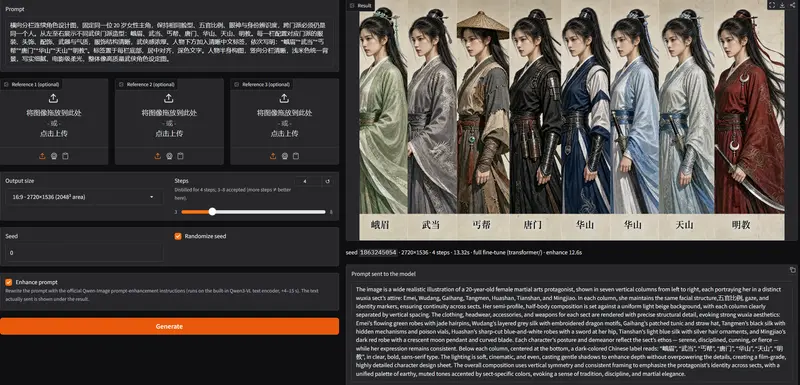
Viggle 发布 Qwen-Image-2.1-viggle-turbo(v0.1 预览版),基于 Qwen-Image-2.1 做分布匹配蒸馏得到学生模型。原生只需要4 次 Transformer 传递,而非原版 40 步,无需无分类器引导,支持文生图,以及带 1~3 张参考图的指令式图像编辑。
Pruna 发布 Pruna-Qwen-Image-2.1,一套面向 Qwen-Image-2.1 的加速LoRA,基于 DMD 蒸馏方案训练,可把原生模型采样步数压缩至5步或8步,最高推理提速6.3倍,支持文生图与图像编辑。
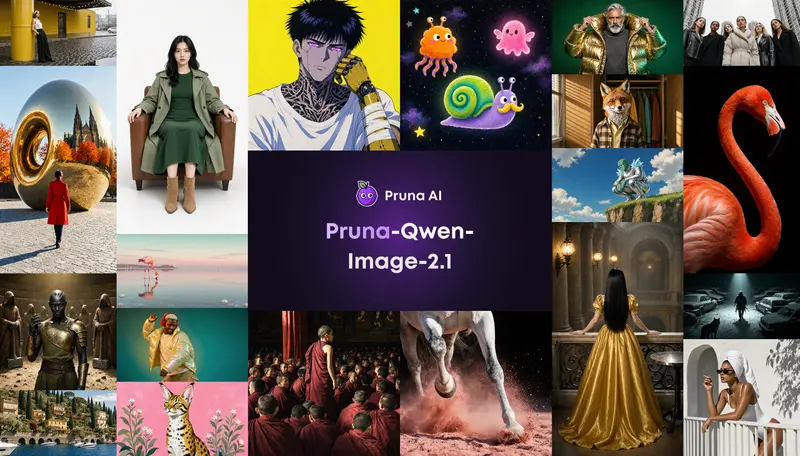
Pruna 发布 Pruna-Qwen-Image-2.1,一套面向 Qwen-Image-2.1 的加速LoRA,基于 DMD 蒸馏方案训练,可把原生模型采样步数压缩至5步或8步,最高推理提速6.3倍,支持文生图与图像编辑。适配器挂载在原版基础模型之上,文本编码器、VAE、原有推理管线无需改动。当前为 v0.1 初版,仍在迭代优化。
| 权重文件 | 采样步数 | 取舍说明 |
|---|---|---|
| p_qwen_image_2.1_8step_v0.1.safetensors | 8 | 画质更好,推荐默认使用 |
| p_qwen_image_2.1_5step_v0.1.safetensors | 5 | 速度最快,图像质量会明显下降 |
两个适配器各自配套专属sigma调度方案,同一时间只能加载其中一个。
版本说明:v0.1 是首次预览发布,图像质量暂时还追不上原版Qwen-Image-2.1基础模型,团队持续优化蒸馏方案,后续会更新仓库。
测试环境:H100 80GB,BF16,batch size=1,使用官方模型卡示例提示词;统计包含提示词编码、去噪、VAE解码,不包含模型加载、预热、图片存储,取预热后3轮推理的中位数。
基于DMD蒸馏方式训练LoRA,专门学习少步采样下的图像分布,减少去噪迭代次数,实现大幅加速,保留原生模型整套组件,不用替换基础权重。
适用场景:需要大批量快速生成图像、实时图像预览、本地端快速出图,适合愿意小幅牺牲画质换取巨大推理速度提升的场景。