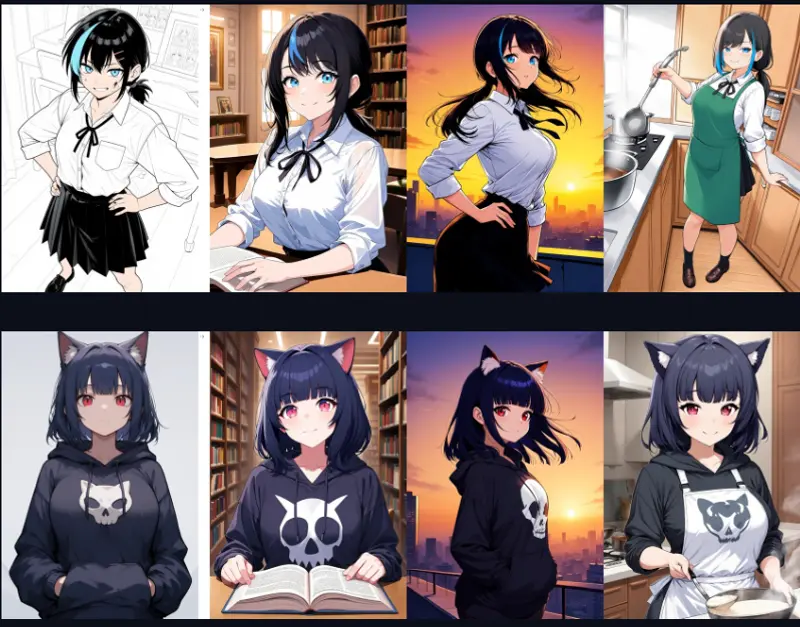
Raena-Qwen-Image
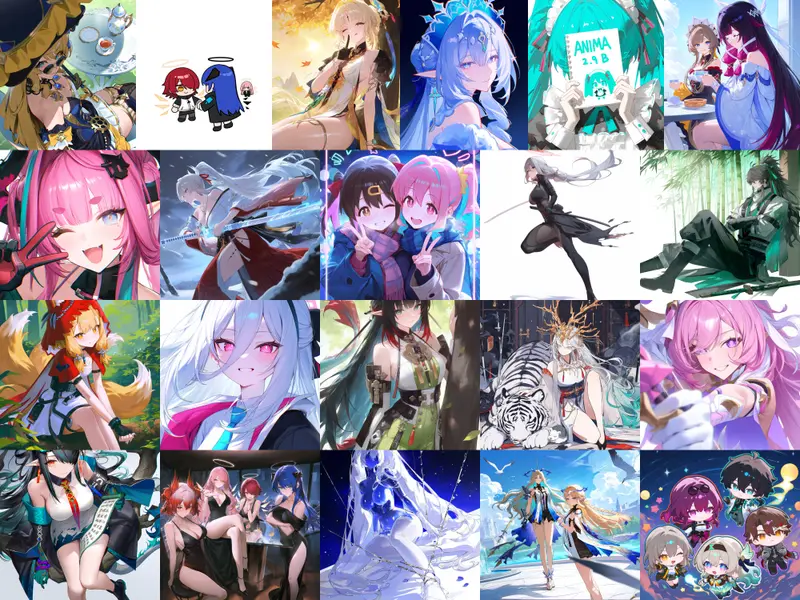
Raena-Qwen-Image 是一个为 Qwen-Image 微调的 LoRA,专为动漫风格生成设计。该模型的目标是增强 Qwen-Image 在生成高质量动漫输出的能力,具有更清晰的细节、更丰富的色彩和更好的美学效果。
Anima-Light-Lavender 是以Anima 系列中的 Anima-Base v1.0为基座、经后训练得到的版本。与基座模型相比,本版本的重点是提升模型对 512 token 量级自然语言描述的理解能力,并借助质量更高的训练数据改善整体生成效果。
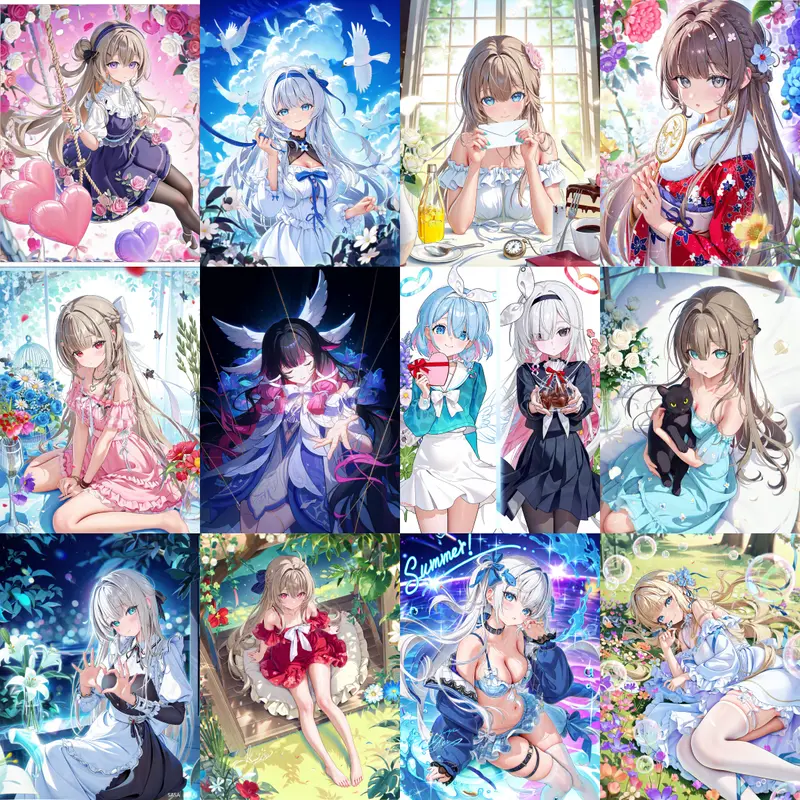
Anima-Light-Lavender 是基于 circlestone-labs/Anima-Base v1.0 的后训练版本,专为提升 512 token 量级自然语言描述的理解能力而优化。该模型保持与基座完全一致的架构(约 2B 参数、28 层 DiT),可直接替换现有 Anima 工作流中的 checkpoint,无需修改文本编码器或 VAE。训练数据包含约 170 万张经内部管线标注筛选的 Danbooru 图像,所有标注、筛选及偏好判别模型均由作者独立训练,数据截止至 2025 年 11 月底。
本版本核心改进在于:以结构化自然语言描述替代传统 tag 堆砌作为默认生成方式,同时通过高质量数据提升画面美感——即使不使用质量词或负向提示词,输出仍保持干净整洁。适用于二次元插画、角色图及风格化艺术创作,但不支持照片写实或长文本渲染。
| 项目 | 说明 |
|---|---|
| 基座 | Anima-Base v1.0 (nvidia/Cosmos-Predict2-2B-Text2Image) |
| 文本编码器 | Qwen3-0.6B (qwen_3_06b_base.safetensors) |
| VAE | Qwen-Image VAE (qwen_image_vae.safetensors) |
| 权重文件 | BF16: anima-light-lavender.safetensorsMXFP8: anima-light-lavender_mxfp8.safetensors(加速推理) |
| 许可证 | CircleStone Labs Non-Commercial License |
ComfyUI 快速部署:
models/diffusion_models,文本编码器与 VAE 放入对应目录(已有 Anima 环境可复用)。comfyui-zako-pe 自定义节点(克隆或下载 ZIP 至 custom_nodes/)。anima.json(基础)或 anima-pe.json(含 tag→自然语言扩写)工作流。⚠️ 关键依赖:anima-pe.json 工作流需本地运行 zako-pe (ZAKO-V0.1) GGUF 模型(LM Studio 默认端口 1234)提供 OpenAI 兼容扩写服务。若仅用 anima.json,则无需此服务,但需手动编写完整自然语言描述。
模型基于固定字段顺序的结构化 caption 训练,示例如下:
{
  "year": 2025,
  "preference_level": "best",
  "artist": ["wlop"],
  "copyright": ["original"],
  "character": ["female knight"],
  "image_description": "A female knight in silver armor standing on a cliff at sunset, wind blowing her red cape, holding a glowing sword, dramatic lighting with lens flare, detailed background of distant mountains and ocean waves.",
  "extra_tags": ["masterpiece", "highres"]
}
字段说明:
year: 年份锚点(整数,默认 2025)preference_level: 偏好档位(normal/high/very_high/best,默认 best)artist/copyright/character: 标准 Danbooru tag 列表image_description: 核心字段,需为详细自然语言描述(非 tag 列表)extra_tags: 补充性 tag⚠️ 注意:字段顺序不可变;image_description 必须是连贯句子而非关键词拼接;preference_level 由 300 万样本训练的偏好模型判定,影响生成质量倾向。
这些选择旨在平衡训练效率与收敛稳定性,尤其针对长文本理解能力的强化。MXFP8 权重的提供进一步降低了推理门槛,使消费级 GPU 也能流畅运行。
anima-pe.json 依赖外部 LLM 服务,离线环境需用 anima.json 并手写描述。