Coloring Book HiDream
Coloring Book HiDream是一个强大的模型,能够为涂色书爱好者和创作者提供高质量的图像资源。通过简单的提示,你可以轻松生成各种风格的涂色书图像。
Rebels W4A8 是一套专为 ComfyUI 优化的扩散与视频模型量化合集,采用 W4A8(4-bit权重 + 8-bit运算) 格式,实现约 0.56字节/参数 的存储与计算密度。其核心优势在于利用 ComfyUI 原生 asym_w4a8_int8 路径,由 int8 张量核心直接执行矩阵乘法,无需反量化回fp16,区别于GGU...
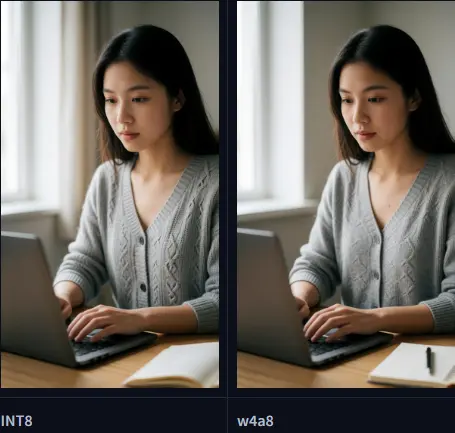
Rebels W4A8 是一套专为 ComfyUI 优化的扩散与视频模型量化合集,采用 W4A8(4-bit权重 + 8-bit运算) 格式,实现约 0.56字节/参数 的存储与计算密度。其核心优势在于利用 ComfyUI 原生 asym_w4a8_int8 路径,由 int8 张量核心直接执行矩阵乘法,无需反量化回fp16,区别于GGUF等仅压缩存储但运行时解压的方案。
转换基于Kijai的AsymW4A8Int8Layout,叠加ConvRot Hadamard旋转、Lloyd-Max非均匀码本、每组fp8缩放三层技术,且无需校准数据集,避免提示词偏向。敏感层(时间步嵌入、条件投影等)强制保持F16/F32精度;输入维度非256整除的层自动降级为int8_tensorwise(~1%误差)。要求ComfyUI ≥0.30.0 + comfy-kitchen内核 + Ampere及以上NVIDIA GPU(sm_80+)。使用标准Load Diffusion Model节点加载,无需自定义节点。
计算路径本质差异
| 维度 | GGUF Q4_K_M | Rebels W4A8 |
|---|---|---|
| 存储密度 | ~0.60 B/元素 | ~0.56 B/元素 |
| 计算路径 | 反量化 → fp16 GEMM | int8 GEMM(端到端) |
| 加载方式 | ComfyUI-GGUF自定义节点 | 标准Load Diffusion Model |
| 权重误差 | 因张量而异 | ~7% relL2(实测可控) |
| 硬件依赖 | CPU/GPU通用 | Ampere+ NVIDIA int8张量核心 |
关键洞察:GGUF的“小文件”不等于“快计算”——每次前向传播仍需解压权重至fp16再计算,内存带宽瓶颈未解。W4A8将计算全程保持在int8域,充分利用Tensor Core吞吐量,文件大小与运行速度同步优化。
三层量化增强
精度保护机制
int8_tensorwise(无组约束,误差~1%)质量保证流程
系统要求
asym_w4a8_int8)asym_w4a8_int8;若在emulated下则无速度优势使用步骤
.safetensors放入ComfyUI/models/diffusion_models/⚠️ 关键警告:蒸馏模型的固定调度不可更改,即使量化版本也必须遵守;使用基础模型设置会导致严重质量下降,与量化无关。
vs 其他量化方案选择
| 需求 | 推荐方案 | 理由 |
|---|---|---|
| 极致显存节省+原生速度 | Rebels W4A8 | 0.56B/param + int8 GEMM |
| 跨平台/CPU推理 | GGUF | 通用加载器,CPU友好 |
| 无损精度优先 | FP16/BF16 | 无量化误差 |
| 中等压缩+易用性 | INT8/FP8原生 | ComfyUI内置,无需额外内核 |