Mirendil 正式发布了其首个 AI 模型 Fern 0.1。该模型专为编码场景从零构建,核心特性是支持高达 1000 万 token 的上下文窗口。这一容量相当于约 23 MB 的代码量或 50 万行代码,允许开发者一次性将整个 Megatron-LM 规模的代码库、完整的训练日志或数天的智能体轨迹加载到上下文中。
- 官方介绍:https://mirendil.com/news/pretraining-at-scale-without-a-pretraining-team
核心定位与构建机制
Fern 的设计明确面向 AI 研发工作,而非通用聊天场景。其目标用途涵盖了在大型代码库中工作、运行命令直至测试通过的智能体编码、研究代码(如训练循环与数据管道)、从长日志和堆栈跟踪中调试训练运行,以及审计预训练分片中的重复或污染数据。
在构建过程上,Fern 0.1 建立在 Mirendil-Base 基础之上,并经过了短暂的后训练轮次。该基础模型的预训练由一名研究人员在 3.5 个月内完成,总计算成本低于 1000 万美元(包含实验、智能体 token 支出与数据处理)。
值得注意的是,该模型的代码有超过 99% 由 AI 智能体编写,研究人员主要负责决策干预时机。训练数据严格限定于公共来源(如 GitHub、公共代码、网页和公共数据集),未使用任何蒸馏数据、合成数据或许可数据。
长上下文能力评估
为验证超长上下文的有效性,Mirendil 在其自有仓库上进行了下一 token 预测测试,将数据拼接成 42.9 MB 的连续流,并以每字节比特数(越低越好)衡量交叉熵损失。
测试结果显示,Fern 的损失值从 32K 字节窗口的 0.246,持续下降至 16M 和 23M 字节窗口的 0.155。
虽然在 100 万字节窗口下,Fern 的得分(0.165)略逊于 Kimi-K3(0.140),但其核心优势在于性能曲线能够延伸至其他模型因上下文限制而停止的长度。
在标准的 RULER 长上下文基准测试中(基于后训练前的 Mirendil-Base 模型,使用贪婪解码与精确字符串匹配),模型展现了稳定的检索能力:
- 单针检索:在 32K 至 1000 万 token 的所有长度上均保持 100% 准确率。
- 多键检索:在 1000 万 token 长度下准确率为 90%。
- 多跳 QA(HotpotQA):在 1000 万 token 长度下准确率降至 45%(该长度下每个单元仅使用 20 个示例,而常规测试为 100 个)。
智能体编码基准表现与局限
在智能体编码能力的横向对比中,Fern 0.1 的表现处于中游水平。根据 Mirendil 提供的对比数据,其在多项基准测试中的通过率如下:
- Terminal Bench 4.0:6.1%(对比 Claude Opus 5.5 为 66.4%,GLM-5.3 为 41.9%)。
- DeepSWE v1.1:44.2%(对比 Kimi-K3 为 67.3%,GLM-5.3 为 66.9%)。
- SWE Atlas QnA:53.2%(对比 Kimi-K3 为 66.1%)。
- SWE-Pro v2 Hard:76.5%(与 Beam 模型并列,落后于 GLM-5.3 的 84.3%)。
- SWE-Bench Verified:73.4%(落后于 Kimi-K3 的 93.4% 与 GLM-5.3 的 95.4%)。
客观而言,Fern 0.1 在 5 项测试中的 4 项上击败了 Inkling 和 Nemotron 3 Ultra,但在整体表现上仍落后于表中列出的所有前沿模型和大型开放权重模型。
关键参数与访问状态
目前,Fern 0.1 仅提供托管早期访问,官方尚未宣布开放权重或提供量化版本。其基础架构参数规模介于 0.1T 至 0.5T 之间(确切数量与激活参数未披露)。
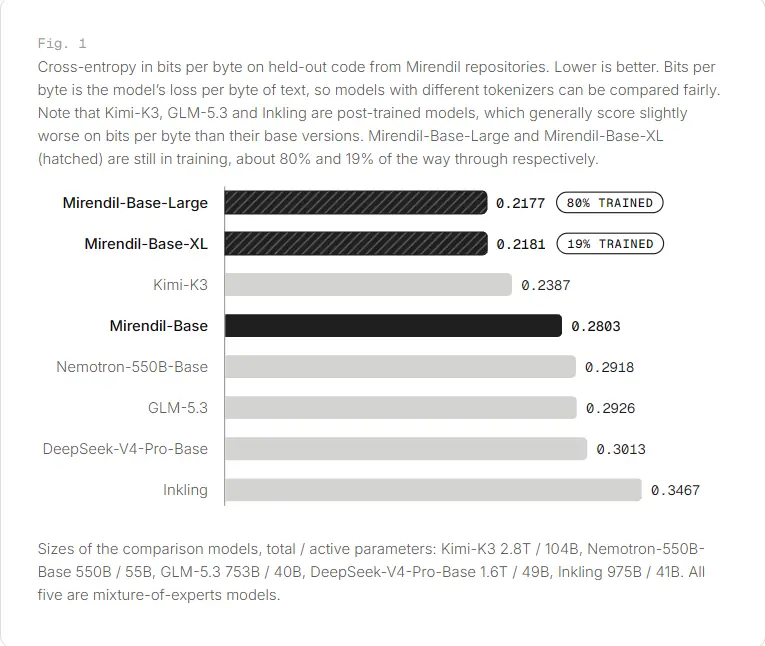
作为 Mirendil 规划中的 3 个模型中最小的一个,其后续路线已明确:参数量在 0.5T 至 2T 之间的 Mirendil-Base-Large 已完成超过 80% 的预训练,而 2T 至 10T 的 Mirendil-Base-XL 也已完成超过 20% 的进度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。