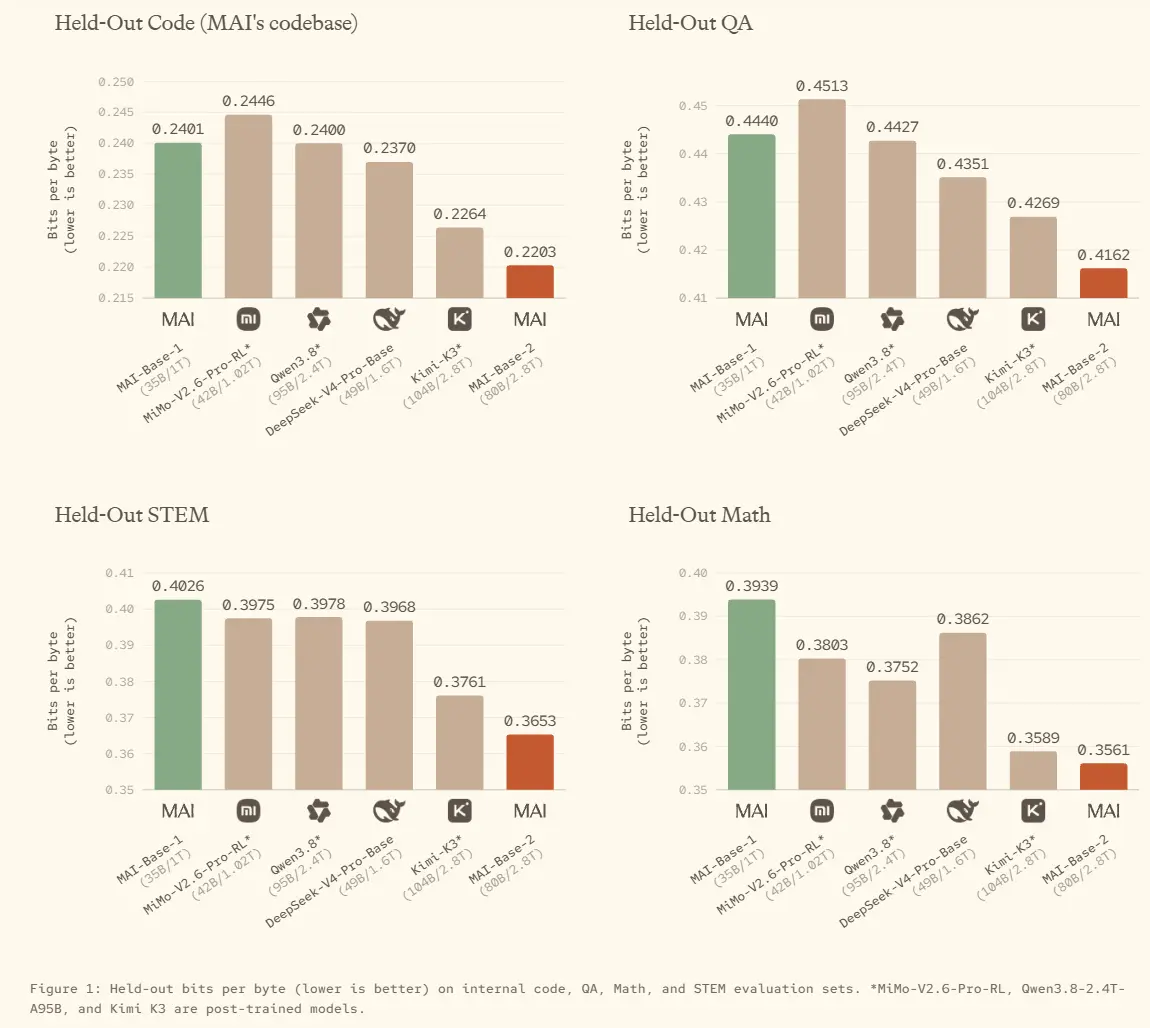
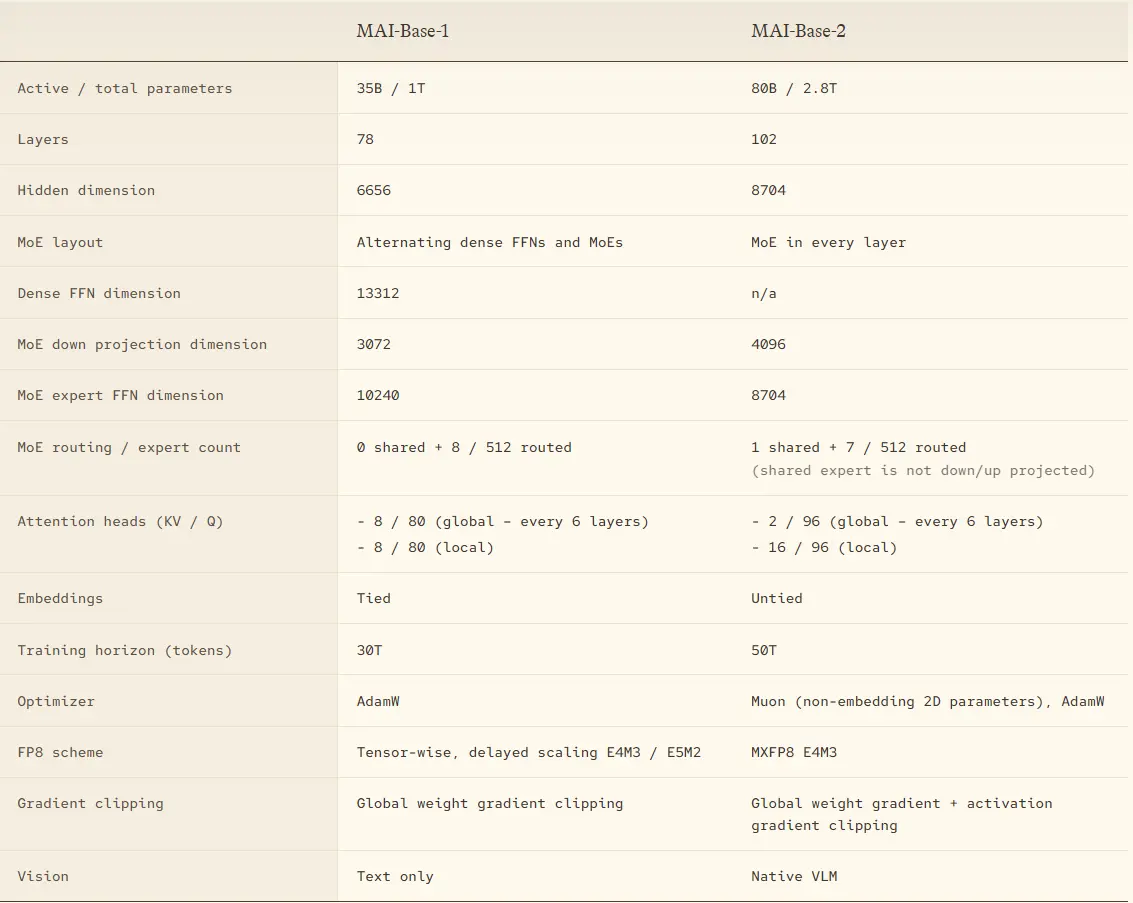
微软宣布新一代MoE基础大模型MAI-Base-2完成全部预训练,在内部保留评测上,该模型性能超过所有参与对比的开源权重模型。MAI-Base-2总参数规模2.8万亿,活跃参数800亿,动用6000片英伟达GB200 GPU,耗时38天完成训练;训练全程模型浮点算力利用率(MFU)21%,有效吞吐量goodput达89%。官方数据显示其预训练FLOPs效率是DeepSeek-V4-Pro-Base的4.2~12.3倍。目前模型进入后训练阶段,同时微软已经启动MAI-Base-3前期筹备工作。
模型定位与训练核心思路
今年6月微软推出MAI-Thinking-1,基于MAI-Base-1做后训练优化。本次MAI-Base-2是规模更大、更稀疏的MoE基座,在更多数据上完成训练。支撑本次大规模预训练的三大关键技术方向:扩展科学、模型与基础设施协同设计、规模化数据管线并集成视觉数据。
微软整套模型管线自研可控,训练数据来源为原生自有数据,不依赖其他模型蒸馏。后续可通过Microsoft Foundry向可信合作伙伴开放权重授权,面向企业场景提供基座能力。模型与底层基础设施协同调优,优先服务微软自有产品,再开放给Foundry企业客户。
评测体系上采用BPB(每字节位数)指标在保留文本集评估,不受不同分词器干扰;代码评测使用微软自有代码库,STEM、数学、问答等委托第三方评测,并且全部数据集做训练集去污染,规避数据泄露带来的评测虚高。对比基准包含DeepSeek-V4-Pro-Base、Kimi K3、Qwen3.8-2.4T-A95B、MiMo-V2.6-Pro-RL等前沿开源模型。微软提示,Kimi、Qwen、MiMo公开的仅为后训练版本,评测结果会受到后训练环节影响。
扩展阶梯与源扩展技术
微软采用扩展阶梯方法开展模型迭代:固定训练配方,训练不同尺寸的模型家族,每层模型独立设计层数、隐藏维度、查询头数量,保证每个活跃参数的训练token数(TPP)恒定。
配套源扩展技术解决多轮数据训练带来的偏差:小规模训练任务中,人为限制唯一样本集,保证数据集重复次数和大规模训练保持一致。该手段固定唯一数据量与参数比例,让小规模实验结论能够平滑迁移到大模型,避免小模型阶段优选的架构在超大模型上过拟合,也是能够稳定训练到2.8T参数规模的核心。
算力效率对比说明
为区分模型配方质量、模型尺寸、总训练算力带来的混合影响,微软以DeepSeek-V4-Pro-Base作为参照,拟合BPB与训练FLOPs的扩展曲线,测算达到同等性能所需算力。测算得出MAI-Base-2配方的算力效率相比DeepSeek-V4-Pro-Base提升4.2–12.3倍;对比前代MAI-Base-1,算力效率提升6.3–12.7倍。效率提升来源于高质量训练数据,以及MoE架构、Muon优化器、激活梯度裁剪等建模层面优化。(来源)
要点小结
- MAI-Base-2:MoE基座,2.8T总参数/80B活跃参数,6000片GB200训练38天,预训练完成,正在进行后训练,下一代MAI-Base-3已启动筹备。
- 评测表现:内部保留BPB指标优于所有参测开源模型,训练FLOPs效率相比DeepSeek-V4-Pro-Base提升4~12倍。
- 核心技术:扩展阶梯+源扩展保证大模型稳定扩容;模型与基础设施协同设计,原生数据训练,无模型蒸馏。
- 商业化路径:通过Microsoft Foundry向可信企业开放权重授权。
© 版权声明
文章版权归作者所有,未经允许请勿转载。