诺基亚应用研究团队开源 AnyJev,一款 Python 工具库,无需训练,就能把任意开源大语言模型改造为 Jev 风格的带类型决策模型。它面向生产场景中从固定候选集合选出答案的任务,区别于自由文本生成。
- GitHub:https://github.com/nokia-applied-research/AnyJev
项目已上传 PyPI,采用 Apache-2.0 开源许可,支持 Transformers、vLLM 后端,内置共享前缀评分机制,可直接部署使用。
核心问题:为何直接读 logits 不可靠
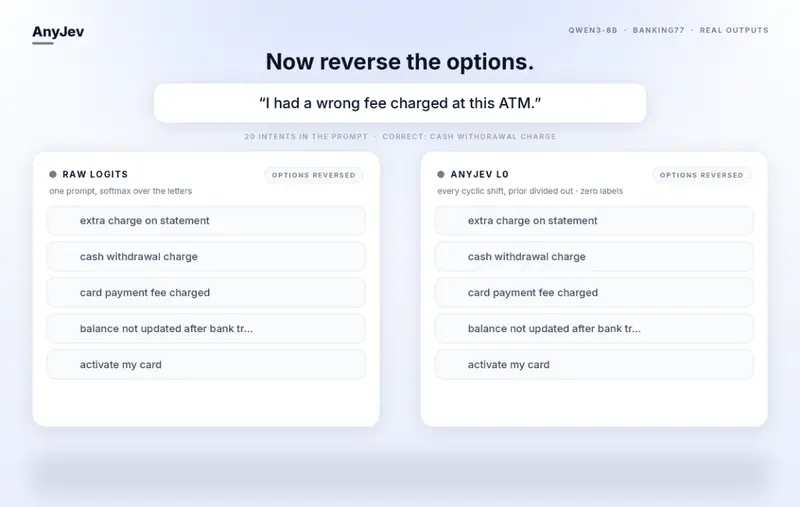
许多开源项目尝试将下一 token 限制到选项标签并读取分数,但存在两大缺陷:
- 先验偏差:模型对特定标签(如“是”>“否”)有固有偏好,与输入无关
- 位置偏差:模型倾向于选择列表中某些位置的选项(如首项或末项)
这导致相同问题仅因选项重排就产生不同答案,且输出概率无法反映真实置信度。
AnyJev 解决方案:L0 与 L1 双层校准
L0(零标签,默认启用)
- 循环移位:对 K 个选项执行 K 次旋转,使每个选项遍历所有位置;结果在对数空间取几何平均,精确消除加性位置偏差
- 批量先验校正:维护真实输入预测分布的运行均值,以 0.75 强度除偏;8 样本后启动
- 性能:单 H100、batch=32、K=20 时,每决策 ~0.25 秒(利用共享前缀批处理)
L1(可选,需 100–500 标签)
- 在 L0 基础上拟合温度缩放参数,重塑置信度分布
- 不改变答案排名,仅提升概率校准精度
- 保存为轻量 JSON 工件,部署时无额外计算开销
基准表现:Qwen3-8B @ BANKING77(20 类,300 测试)
| 指标 | 原始 Logits | AnyJev L0 | AnyJev L1 |
|---|---|---|---|
| 所需标注数据 | 0 | 0 | 100–500 |
| 选项反转翻转率 | 23.0% | 7.3% | 7.7% |
| 准确率 | 74.7% | 80.3% | 80.7% |
| 校准误差 (ECE) | 0.240 | 0.184 | 0.095 |
| 5% 误差下可自动决策比例 | 7.7% | 46.3% | 52.0% |
💡 关键洞察:
- L0 在所有 9 个模型×任务组合上均降低顺序翻转
- Qwen3-32B + L1 在类型化决策集上 ECE=0.036,优于 Jev 公布的 0.144
- 微调模型(如 Laya)在准确率上仍领先,但 AnyJev 提供零训练替代方案
快速上手指南
安装
pip install "anyjev[hf]"      # Hugging Face 后端
# 或
pip install "anyjev[vllm]"   # vLLM 后端(推荐服务部署)
基础用法
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

d = Decider(HFBackend("Qwen/Qwen3-8B"))
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route"
)
result = d.decide({"conversation": [...]}, [route])
print(result["route"].distribution)  # {'billing': 0.62, 'technical': 0.28, ...}
服务部署
启动带前缀缓存的 vLLM 服务器,使用 VLLMBackend 连接,即可获得高吞吐低延迟推理。
适用场景
✅ 推荐使用:
- 客服工单自动路由
- 内容审核多级分类
- 意图识别槽位填充
- 任何需从固定集合选择且要求概率可信的场景
- 无法微调或需快速验证的开放模型评估
⚠️ 注意事项:
- 非生成任务专用:不适用于开放式问答、摘要、创作等生成场景
- L1 需少量标注:100–500 条带标签数据用于温度拟合,纯零样本请用 L0
- K 较大时成本上升:L0 需 K 次 prefill,K>50 时建议评估延迟是否可接受
- 校准≠准确:ECE 低不代表准确率高;业务阈值应基于验证集设定
- 模型依赖性:效果因基座模型而异,务必在目标任务上实测
© 版权声明
文章版权归作者所有,未经允许请勿转载。