科大讯飞正式推出 Spark-Audio-1.0-Preview,一款依托全国产算力集群完成训练的语音基座大模型。它跳出传统“语音转文字再交给大模型”的级联方案,实现对音频信号的直接理解。
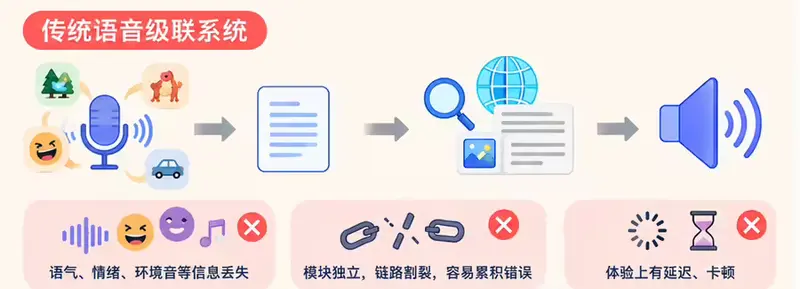
传统语音方案的两大痛点
过往音频处理大多采用串联链路:语音先转写文本,再送入大模型处理。
- 信息丢失:文字只能保留话语内容,丢失语气、情绪、背景环境音,模型无法完整感知场景;
- 链路割裂:语音转写、声纹识别、翻译拆成独立模块,错误逐层累积,同时带来延迟、卡顿问题。
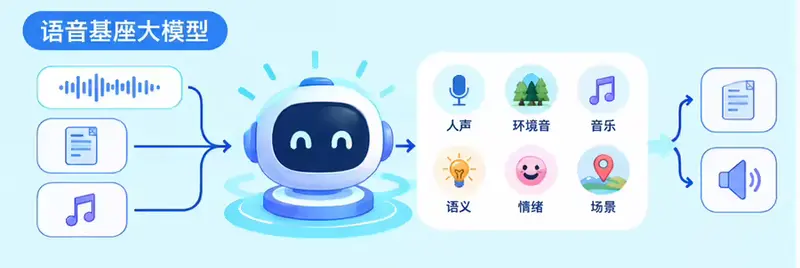
语音基座模型则直接对原始音频进行理解,一次性识别人声、环境音、音乐,同时捕捉语义、情绪与场景信息。
模型架构与训练数据
Spark-Audio-1.0-Preview 采用0.65B参数量的Dense音频编码器,搭配30B-A3B MoE结构大语言模型;训练数据包含1300万小时音频以及海量文本,全程基于国产算力集群训练。
模型支持文本、语音双模态输入,单模型覆盖语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析、音频问答等任务,推动AI从“听清声音”升级为“听懂声音”。
评测表现
- 支持99种语言 + 202种方言识别;多语言、多方言识别能力优于同规模Qwen3.5-omni-flash,和更大规格的Qwen3.5-omni-plus效果接近。
- 在Fleurs、Kespeech、LibriSpeech等评测集,多项语音识别指标优于Gemini-3.1 Pro;Fleurs中文测试集取得SOTA成绩。
- 高噪声、低音量这类贴近真实使用的复杂场景,模型优势明显;整体性能对标更大体量闭源语音基座模型。
- 通用知识、数学、代码能力没有明显下降,但指令遵循、对话、音频理解仍有优化空间。
和星火1+N体系思路一致,该基座模型支持微调,可衍生语音识别、同声传译、语音交互等专用模型,落地各类语音业务。
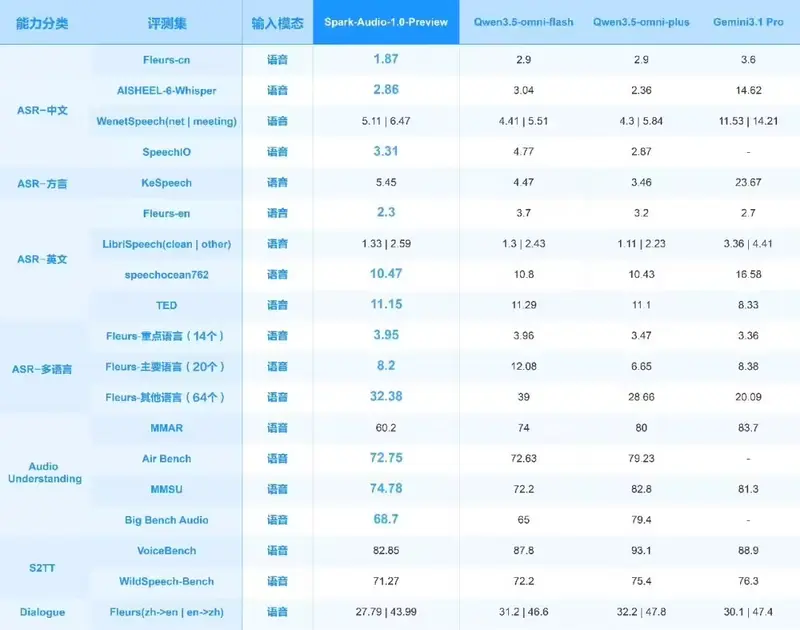
评测指标说明:ASR语音识别用WER/CER,数值越低越好;S2TT语音翻译采用BLEU;其余任务以准确率衡量,数值越高越好。
上线信息
Spark-Audio-1.0-Preview现已开放体验,对应的API后续会在讯飞开放平台上线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。