在数学界,千年奖问题一直是皇冠上最耀眼的难题,每一道都悬赏100万美元。纳维-斯托克斯方程,正是其中至今悬而未决的重大课题。而最近,围绕这个难题,一场和OpenAI相关的争议正在发酵,也给所有把研究草稿放进AI工具的研究者敲响警钟。
纳维-斯托克斯方程诞生于1822年,用来描述水、空气、烟雾、油料等所有流体的运动规律。从天气预报到飞机设计,现实世界大量工程场景都依赖这套方程。但有一个核心疑问至今没有被证明:在所有场景下,方程是否总能输出合理平滑的结果,还是在特定条件下,计算结果会走向无穷大,也就是数学意义上的“崩溃”。这就是千年奖要解答的核心。
数学家 Tristan Buckmaster 与 Levent Alpöge 近期公布重要研究成果,证明一类相关流体方程会出现有限时间爆炸:即便初始条件完全平滑,方程在特定外力作用下,解依然会在有限时间内失效。知名数学家陶哲轩评价,这是一项非凡成果,极大推进了流体方程爆炸解方向的研究。
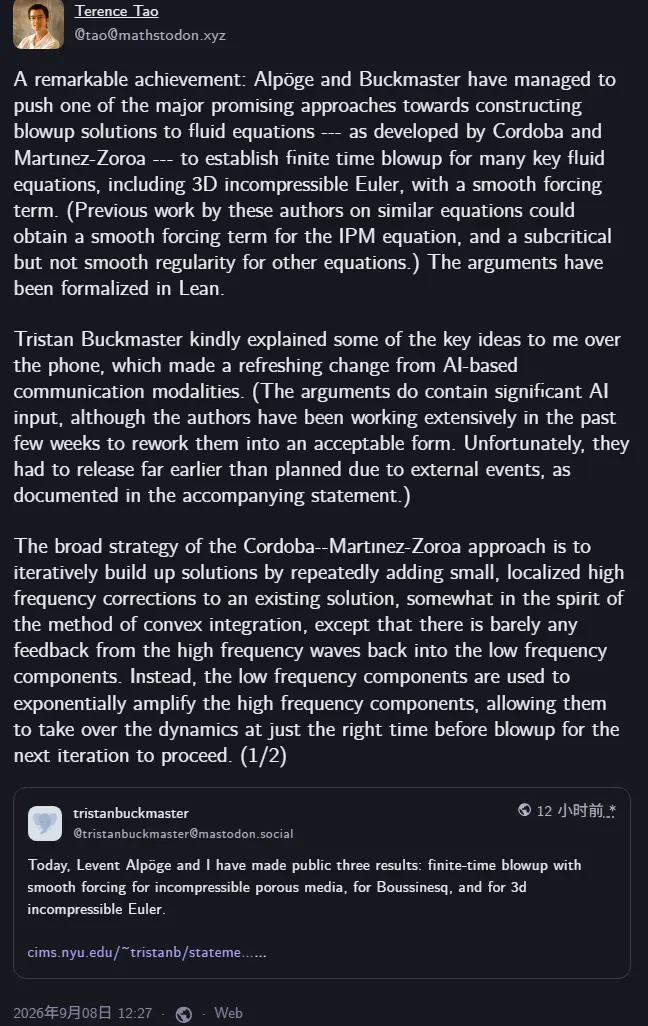
但就在这项成果公布前后,争议随之而来。
Buckmaster 在社交平台Mastodon发文,讲述了他和OpenAI之间的一段对话。OpenAI主动联系他,告知其团队似乎找到了纳维-斯托克斯问题的解法。
Buckmaster 随即提出关键疑问:自己团队整个项目的全部草稿、研究笔记,都保存在Codex当中,OpenAI的模型是否读取、使用了这些会话数据用于研究或模型训练?
对方告诉他模型不会检索用户数据;但当他继续追问训练相关细节时,却没有得到答复。
这位数学家直言,他认为OpenAI拥有访问这些研究资料的能力,对此表达强烈质疑。他感慨,将自己的核心研究资料交给这类AI工具,就要承担对应的风险。
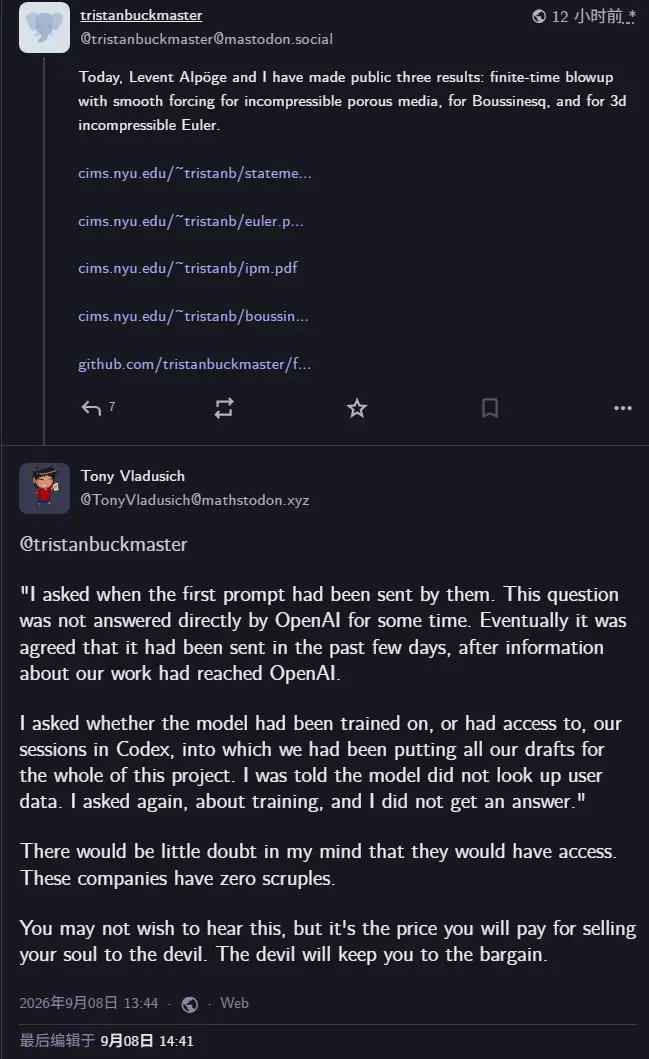
简单来说,争议的核心是:研究团队把未公开、属于原创的前沿数学草稿,保存在OpenAI Codex会话内;如今OpenAI宣称在同一重大难题上取得进展,研究者怀疑自己的笔记被对方取用。
OpenAI方面仅表示模型不会检索用户数据,却没有正面澄清这些Codex会话内容是否被纳入训练素材,这也让怀疑持续发酵。
这件事也打破很多人对AI工具隐私保护的幻想。很多科研人员习惯把草稿、思路、未发表的成果丢进AI代码/助手工具,方便整理、辅助推导。但这起争议提醒大家:高价值的私有研究内容,存入AI平台时,需要警惕数据使用边界。
目前双方各执一词,事件尚无定论。不少观点认为OpenAI需要发布完整说明,回应这项严肃质疑。对于科研工作者而言,这件事带来最直观的警示:重要、未公开的原创研究材料,不要轻易上传到第三方AI平台。
© 版权声明
文章版权归作者所有,未经允许请勿转载。