Reducto 推出新一代文档解析模型家族首款产品 r‑1,重构底层架构,摒弃原有的多阶段代理OCR流水线,改为单次整页通过处理模式。官方数据对比自家旧版代理模型,r‑1速度更快、精度提升,最高可把处理成本压低6倍。
- 文档地址:https://docs.reducto.ai/parse/r-1
部署状态:目前为预览版本,依托 Reducto V3 托管 Parse API,通过配置开关启用;无开源权重,不支持本地自行部署。平台支持多租户云、客户VPC、本地部署隔离环境,高阶方案可提供 SOC 2 Type II、HIPAA合规处理。
从多阶段流水线进化为单次整页通过
传统文档解析方案,把OCR识别、布局检测、后处理拆成相互独立步骤,再叠加代理视觉语言能力,每多一轮模型调用就叠加一层延迟。
r‑1把文本、表格、图表、页面布局、阅读顺序、排版格式、坐标定位全部整合进单次页面推理。输出内容附带页面相对边界框,把提取内容和它在文档页面当中的物理位置一一绑定。
它瞄准的不只是单纯字符识别准确率,更是企业处理财务报表、保险单据、合同时,多工具串联带来的复杂编排开销。
性能与定价
- 错误率:对比 Reducto 原有代理流水线,错误率降低20%(仅对比自家旧版本,非第三方基线)。内部评测显示在复杂文档场景优于部分主流云厂商文档解析与大模型方案,基线包含 Amazon Textract、Azure Document Intelligence;该对比为厂商自测,未公开评测数据集。
- 价格:旧代理模型每页 3‑6 美分;r‑1统一每页1美分,全包定价,不会因为开启高级能力额外加价。
r‑1原生支持解析内容
单次推理即可处理:印刷文本、扫描件、手写内容;复杂表格,包含合并单元格、嵌套表头;多栏排版、页眉页脚、侧边栏、正确阅读顺序;图表附带简短描述;各类格式标记,标题、列表、粗体、下划线、删除线;全部元素附带页面坐标框。
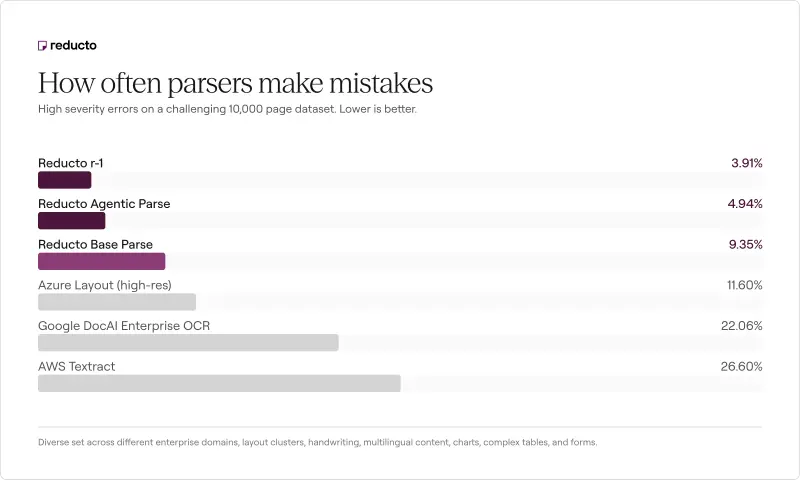
重点优化长尾难题:高密度表格、非常规版式、低质量扫描件、带水印文档、无固定模板的非标准化文件。
合同删除线识别出错、表格数字解析偏差,会直接造成业务结果出错,这类边缘场景在合规业务链路中至关重要。
迁移方式与原有能力保留
r‑1依赖 V3 Parse API。不指定 settings.model 的请求会继续运行旧解析引擎,不会静默切换。Studio 新建流水线默认启用 r‑1。
Python调用示例:
result = client.parse.run(
    input=upload.file_id,
    settings={"model": "r-1"}
)
代理处理链路并未移除。需要自定义提示词、高级图表提取的任务,依旧可以把页面交给代理流水线,叠加在 r‑1 的解析结果之上,代价是延迟上升。迁移前需要查阅兼容性文档,部分旧参数不再生效。
产品路线规划
- r‑1 mini:面向对速度、成本高度敏感的业务负载。
- 自动逐页路由:系统自动为每一页文档挑选最合适的解析模型。
从其他解析服务商迁移的企业,可申请最高5000美元额度用于并行效果比对。
© 版权声明
文章版权归作者所有,未经允许请勿转载。