谷歌正式在其 Gemini Flash 系列模型中引入了代理式视频理解(Agentic Video Understanding)功能。这一创新彻底改变了 AI 处理长视频的方式,从传统的“全盘摄入”转变为智能的“按需导航”,从而实现了成本的显著降低和准确率的提升。
核心突破:从“被动观看”到“主动探索”
传统视频处理模型(包括此前的 Gemini)通常采用静态处理模式:以固定的每秒 1 帧速率提取画面,并以固定比特率处理音频,无论用户的问题是概括全文还是查找特定细节,模型都必须处理整个时间线。这导致了巨大的计算浪费和昂贵的令牌成本。
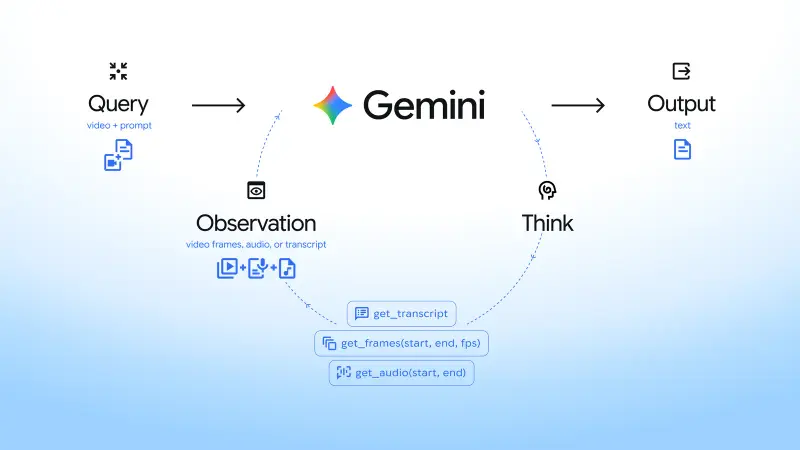
代理式视频理解则赋予了 Gemini “眼睛”和“大脑”:
- 智能导航:模型不再盲目吞食所有数据,而是像人类一样,根据提示词决定看哪里、以什么速度看以及关注哪种模态(视觉、音频或转录稿)。
- 循环推理:模型内部运行一个搜索-扫描-检查的循环,仅加载回答问题所需的片段。
- 工具调用:模型使用原生视频工具来定位关键帧、检索特定时间段的音频或查阅转录稿。
性能与成本优势
谷歌的评估数据显示,代理式模式在长视频处理上表现卓越:
| 指标 | 提升幅度 | 说明 |
|---|---|---|
| 视频令牌减少 | 高达 88% | 仅处理必要片段,大幅降低数据传输与处理量。 |
| 成本降低 | 高达 66% | 直接转化为更低的 API 调用费用。 |
| 准确率提升 | 高达 7% | 在标准视频基准测试中,因聚焦关键信息而表现更佳。 |
适用场景:特别适合 10 分钟以上的操作指南、数小时的讲座录音或会议记录等长格式内容。对于 5 分钟以下的短视频或需要逐帧精确分析的任务,静态模式仍可能是更优选择。
开发者集成与 API 变化
该功能目前仅作为托管 API 提供,支持 Gemini 3.8、3.7、3.6 Flash 及 3.5 Flash-Lite 模型。
- 启用方式:在 API 请求中添加
processing字段即可激活。 - 透明化步骤:API 响应中的
steps数组会新增两种步骤类型:processing_call:模型请求加载某片段或转录稿。processing_result:加载完成并返回结果。- 这些步骤与
thought交错出现,允许开发者在 UI 中展示实时进度条,增强用户体验。
- 计费拆分:
- 思维令牌 (
total_thought_tokens):用于导航和推理逻辑。 - 工具使用令牌 (
total_tool_use_tokens):用于实际加载的帧、音频和文本。
- 思维令牌 (
- 混合模式:支持在同一请求中对不同视频采用不同模式(如长视频用代理式,短视频用静态)。
实际意义
- 消除开发开销:此前开发者需手动编写复杂的视频切片、索引和检索逻辑来实现类似效果。现在,这一复杂流程由 Gemini 内部自动完成。
- 让长视频分析变得经济可行:高昂的成本曾是阻碍企业大规模分析培训视频、监控录像或媒体库的主要瓶颈。代理式模式将这一门槛大幅降低。
- 更精准的问答:由于模型能“回头重看”或“快进跳过”,它在回答诸如“演讲者何时切换到定价幻灯片?”这类具体问题时更加准确。
© 版权声明
文章版权归作者所有,未经允许请勿转载。