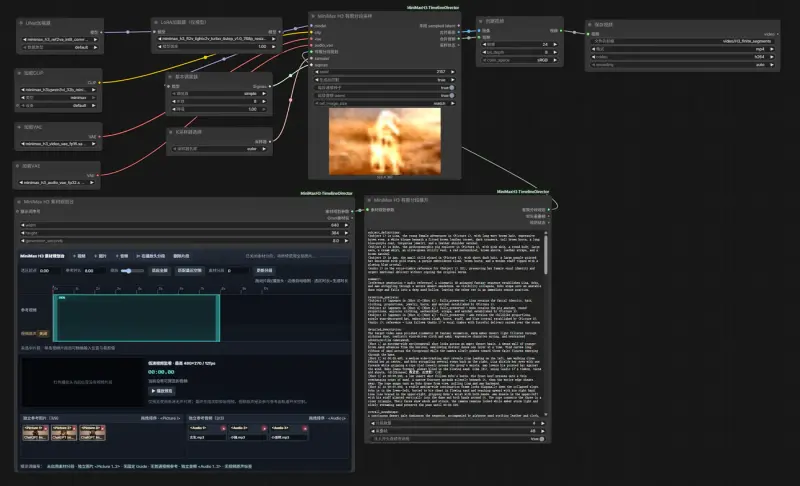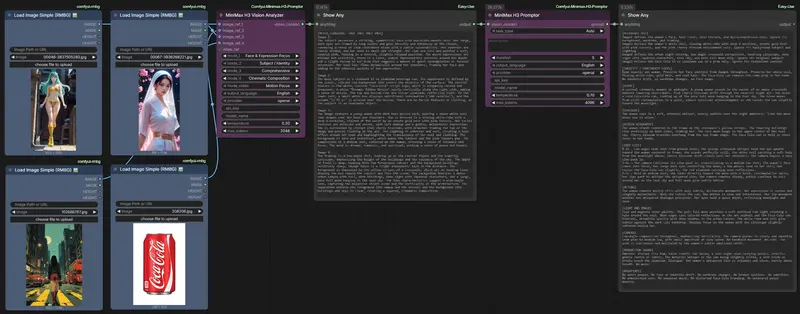
在 ComfyUI 中处理 MiniMax H3 这种复杂的音视频多模态模型时,标准的放大流程往往会失效。这是因为 H3 使用了一种特殊的 NestedTensor AV 隐空间结构(视频 [B,24,T,H/16,W/16] + 音频 [B,32,2,T_audio]),传统的 LatentUpscaleBy 或 AddNoise 节点无法正确解析这种嵌套结构,导致报错或生成损坏的媒体。
- GitHub:https://github.com/Tr1dae/ComfyUI-MiniMaxH3_LatentUpscaler
MiniMaxH3_LatentUpscaler 是一个非学习型的自定义节点,专门用于在 MiniMax H3 的采样器之间进行隐空间的空间放大。它不仅能正确处理视频和音频张量,还能同步缩放参考图像(Ref2VA)的视觉隐空间,确保身份和构图的一致性。
核心功能:解决 NestedTensor 放大难题
1. 智能张量处理
- 视频放大:通过
F.interpolate对 NestedTensor 中的视频部分进行高分辨率(H, W)放大。 - 音频透传:音频张量直接传递,保持时序同步,避免因空间操作导致的音画不同步。
- 条件同步:如果连接了
positive/negative条件,节点会自动对minimax_refs或minimax_keyframes中的视觉隐空间进行同步放大,并更新latent_h/latent_w元数据。这对于防止 Ref2VA 模式下的身份扭曲至关重要。
2. 两阶段重加噪策略
为了在放大后恢复细节,节点支持在 sigmas[0] 处重新引入噪声:
- Video Noise:通过
noise_scaling和inverse_noise_scaling控制视频部分的噪声注入。 - Audio Denoise (0–1):专门针对音频的重新加噪程度。
0:锁定第一遍生成的音频,保持不变。1:完全重新混合,允许第二遍采样器改善音频质量。0.25–0.5:轻度润色,平衡稳定性与细节提升。
3. 显存优化
节点在执行放大前会将 LATENT 移至 CPU 并执行 soft_empty_cache,在不卸载模型的前提下释放显存压力,确保两遍采样流程的顺畅运行。
推荐工作流:两遍采样法
为了实现最佳的高清效果,建议采用以下“低分辨生成 -> 放大 -> 高分辨细化”的流程:
- 第一遍(低分辨率):
- 使用
SamplerCustomAdvanced #1在较低分辨率下生成视频。 - 设置较高的主要 $\sigma$ 值,完成主体结构和动作的构建。
- 获取
denoised_output。
- 使用
- 放大阶段:
- 将
denoised_output输入 MiniMax H3 Latent Upscale Combined 节点。 - 设置
scale_by(如 2.0)。 - 连接相同的
positive/negative条件,确保参考信息同步放大。 - 设置
audio_denoise(推荐 1.0 用于全面优化,或 0.35 用于温和调整)。
- 将
- 第二遍(高分辨率细化):
- 使用
RandomNoise生成低 $\sigma$ 噪声。 - 使用
SamplerCustomAdvanced #2(禁用噪声注入DisableNoise),结合放大后的隐空间和新的 Guider 进行细化。 - 提示:如果音频出现杂音,可在第一遍增加调度步骤,或降低
audio_denoise值。
- 使用
为什么必须缩放条件控制(Ref2VA)?
在 MiniMax H3 的 Ref2VA 模式中,参考图像与其隐空间及 latent_h/latent_w 是打包在一起的。如果目标画布放大 2 倍,而参考隐空间未同步放大,参考内容相对于新画布的比例就会出错,导致 RoPE 行布局不匹配,进而引发严重的身份扭曲或构图崩坏。MiniMaxH3_LatentUpscaler 通过同时放大参考视觉隐空间和元数据,完美解决了这一问题。
安装与注意事项
- 安装:将仓库克隆至
ComfyUI/custom_nodes/MiniMaxH3_LatentUpscaler/,重启 ComfyUI。 - 显存管理:在两遍采样之间,避免使用
Easy-Use Empty Cache或强制卸载模型。特别是在使用--disable-dynamic-vram、量化模型及 SageAttention 组合时,保持模型驻留显存能显著提升切换效率。
© 版权声明
文章版权归作者所有,未经允许请勿转载。