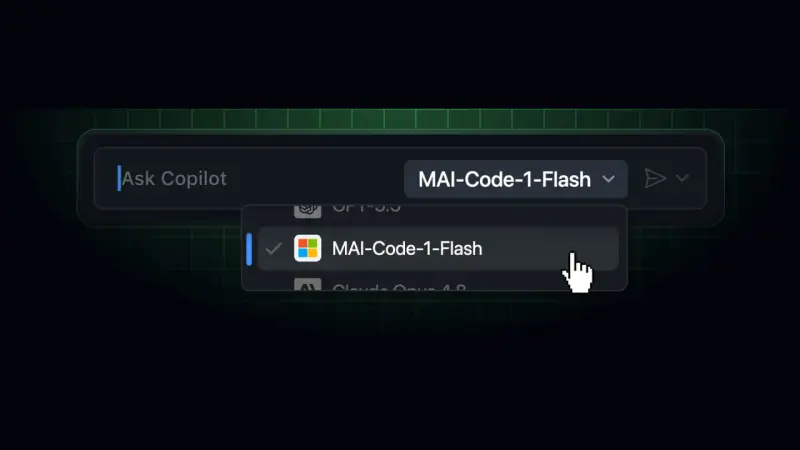
微软近日宣布,其自研的轻量级编程模型 MAI-Code-1-Flash 正式面向 GitHub Copilot Business 和 Copilot Enterprise 客户开放。这一举措标志着微软在为企业提供更集中策略控制和基于令牌的精细化计费方面迈出了重要一步,同时也为开发者提供了一个专注于速度与效率的新选择。
核心定位:速度与迭代的首选
MAI-Code-1-Flash 并非旨在取代处理复杂架构设计或深度调试任务的大型模型,而是专为快速、迭代式的编程工作而设计。根据 GitHub 的官方描述,该模型在以下方面表现优异:
- 通用编程与写作:擅长处理日常代码编写和文档生成。
- 极速补全与解释:提供低延迟的代码补全建议和清晰的代码逻辑解释。
- 高 token 效率:在 SWE-Bench Verified 基准测试中,相比其他模型最多可减少 60% 的令牌使用量。
性能表现:超越同级竞品
在微软自行运行的基准测试中,MAI-Code-1-Flash 展现了强劲的实力:
- SWE-Bench Pro:得分 51.2%,显著高于 Anthropic 的 Claude Haiku 4.5(35.2%)。
- 多平台支持:除了 Copilot Business/Enterprise,该模型已扩展至 Copilot CLI、云智能体、GitHub.com 聊天、移动端以及 Visual Studio、JetBrains、Eclipse 和 Xcode 等主流 IDE。
(注:以上数据来自供应商内部测试,未经独立第三方验证)
企业级管理与计费
对于企业管理员而言,MAI-Code-1-Flash 的引入带来了更精细的控制能力:
- 管理员启用机制:默认情况下该模型不开放,必须由 Business 或 Enterprise 计划的管理员在 Copilot 设置中手动启用相应策略后,开发者方可访问。
- 基于令牌的计费系统:
- 使用量通过 GitHub 的 AI 信用系统进行计费。
- 输入价格:$0.75 / 百万 tokens
- 缓存输入价格:$0.075 / 百万 tokens
- 输出价格:$4.50 / 百万 tokens
这种计费模式使得组织能够更清晰地追踪和控制 AI 辅助编程的成本,特别是在大规模重复性智能体任务中,轻量级模型的高效率能显著降低开支。
使用建议与最佳实践
尽管 MAI-Code-1-Flash 在速度上具有优势,但微软建议团队在使用时保持理性:
- 适用场景:快速原型开发、日常代码补全、简单脚本编写及大规模自动化任务。
- 不适用场景:涉及大量上下文的超大仓库分析、安全敏感型代码更改、复杂的多文件重构。
- 交叉验证:对于关键任务,建议将 Flash 模型的输出与其他更大、更强大的模型进行对比,以确保代码的质量和安全性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。