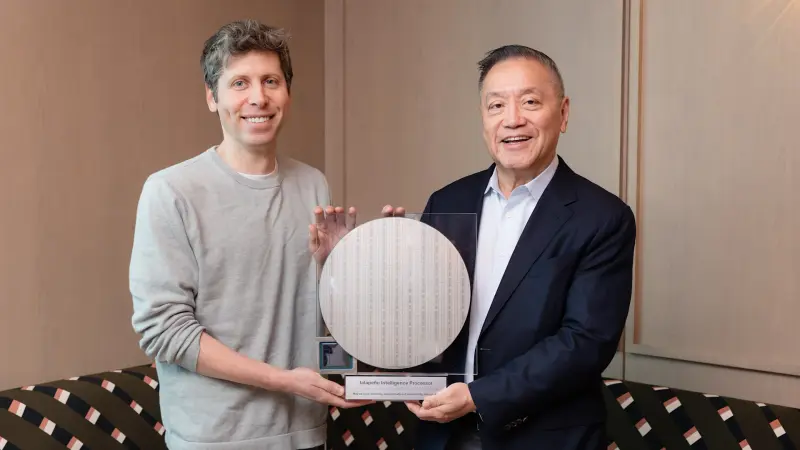
OpenAI 与半导体巨头博通(Broadcom)正式推出了 Jalapeño,这是 OpenAI 首款专为大型语言模型(LLM)推理和未来智能体(Agent)工作负载设计的定制 ASIC 芯片。这款被定义为“巨型光罩尺寸”的处理器,旨在解决大规模推理中的能效瓶颈,其每瓦性能据称显著优于当前最先进的通用 AI 加速器。
核心定位:为推理而生,而非训练改装
与市场上许多由训练加速器改造而来的推理芯片不同,Jalapeño 是从零开始为 LLM 推理行为量身定制的。OpenAI 硬件项目负责人 Richard Ho 表示,该架构基于对前沿 AI 模型内核、内存移动、网络效率及服务模式的深刻理解而构建。
- 高吞吐与低延迟并重:专为处理复杂的智能体工作负载设计,兼顾大规模并发请求的处理能力与实时响应的低延迟需求。
- 极致能效:通过优化计算与内存资源的平衡,减少昂贵的数据移动,Jalapeño 能够实现接近理论最大值的硬件利用率,从而在成本和功耗上具备极高竞争力。
- 早期验证:工程样品已在实验室中以目标频率运行,并成功执行了如
GPT-5.3-Codex-Spark等复杂的机器学习工作负载。
硬件规格推测:840 平方毫米的“巨无霸”
尽管官方未披露详细规格,但通过对晶圆和封装图像的分析,可以窥见 Jalapeño 的强大实力:
- 巨型计算核心:估算芯片尺寸约为 25.46mm × 33mm,面积接近 840 平方毫米。这几乎达到了 EUV 光刻系统单次曝光的光罩极限,使其成为市面上最大的推理芯片之一,甚至媲美许多训练级处理器。
- 高带宽内存配置:封装周围环绕着 6 个 HBM 模块(推测为 HBM3 或 HBM4),确保了极高的内存带宽以支撑庞大的参数加载。
- 脉动阵列架构:从规则的柱状布局来看,Jalapeño 可能采用了类似 TPU 的脉动阵列或高度模块化的矩阵引擎,这种设计非常适合 LLM 中密集的矩阵乘法运算。
研发奇迹:9 个月完成流片
Jalapeño 最引人注目的成就之一是其极快的开发速度。从设计到流片仅耗时 9 个月,远低于传统 ASIC 1.5 至 2 年的周期。这一速度的实现得益于:
- AI 辅助设计:OpenAI 利用其自身的大模型加速了芯片部分的设计与优化工作。
- 博通的模块化复用:博通广泛复用了其在不同定制设计中验证过的逻辑模块,大幅缩短了开发路径。
部署计划与战略意义
- 2026 年底部署:Jalapeño 计划于 2026 年底开始在数据中心大规模部署。
- 千兆瓦级数据中心:博通 CEO Hock Tan 透露,该芯片将作为微软及其他合作伙伴千兆瓦级数据中心基础设施的核心组成部分。
- 潜在的第三方销售:虽然目前主要服务于 OpenAI 及其紧密合作伙伴,但未来不排除向行业其他玩家提供 Jalapeño 的可能性,前提是产能充足。
© 版权声明
文章版权归作者所有,未经允许请勿转载。