ComfyUI 社区迎来重大更新,正式实现了对 Google Gemma 4 系列模型的原生文本生成支持。此次更新不仅涵盖了 E2B (2B)、E4B (4B) 和 31B 三个参数量级,更引入了视频/音频处理、KV Cache 共享及逐层输入机制等前沿特性。
- 官方介绍:https://github.com/Comfy-Org/ComfyUI/pull/13376
- Hugging Face:https://huggingface.co/Comfy-Org/Gemma4/tree/main/text_encoders
- ModelScope:https://www.modelscope.cn/models/Comfy-Org/Gemma4
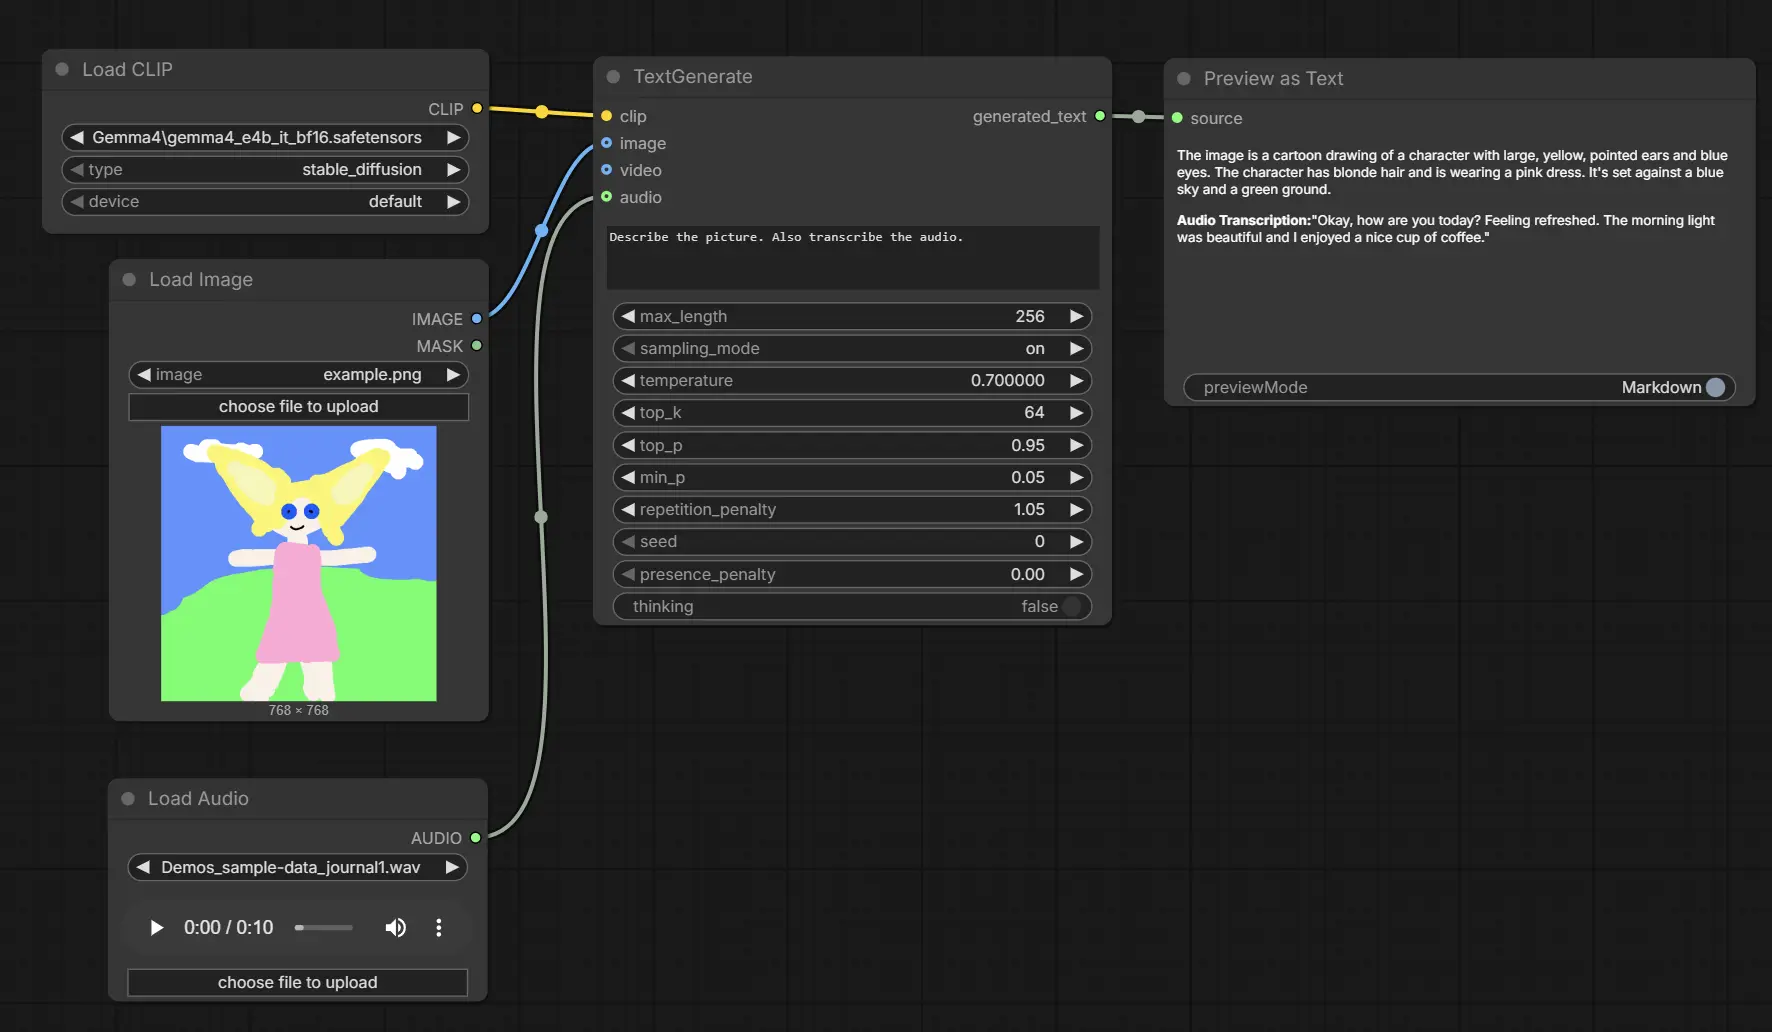
核心亮点与新特性
1. 全家族支持
- Gemma 4 E2B/E4B:轻量级模型,适合本地快速推理和边缘设备部署。
- Gemma 4 31B:高性能模型,提供接近旗舰闭源模型的复杂逻辑推理与创作能力。
2. 多模态能力扩展
- 视频与音频处理:不再局限于图文,ComfyUI 现在可以直接处理视频帧序列和音频嵌入,为构建多模态智能体(Agent)和视频理解工作流奠定基础。
- 统一图像嵌入缩放:修复并统一了图像嵌入的缩放方法,确保视觉特征与文本特征在对齐空间中的一致性。
3. 性能优化与内存管理
- KV Cache 共享:支持键值缓存共享,显著减少重复计算,提升长上下文对话和多轮交互的效率。
- 逐层输入机制 (Layer-wise Input):优化数据流向,减少显存峰值占用,使更大参数量的模型在消费级显卡上运行成为可能。
- FP8 嵌入支持:针对 Gemma 4 巨大的
embed_token权重,引入 FP8 缩放嵌入支持。在混合精度操作中,这不仅大幅降低显存需求,且保持了极高的数值稳定性。
4. 精度与兼容性保障
- 100% 输出一致性基准:在进行任何 ComfyUI 特定优化前,实现已与 Hugging Face
transformers参考版本达到完全一致的输出结果。 - 原生 SDPA GQA 支持:利用 PyTorch 原生的缩放点积注意力(SDPA)和分组查询注意力(GQA),在保证速度的同时避免手动实现带来的微小数值误差。
- 可调试性增强:保留大部分调试路径,并提供选项禁用融合的 RMS Norm,方便开发者排查兼容性问题或进行底层研究。
技术细节与修复
- Gemma 3 遗留问题修复:在开发过程中,团队发现并修复了此前 Gemma 3 文本生成实现中的若干细微错误,提升了整体稳定性。
- 随机性控制:虽然由于底层算子(如 SDPA)的细微差异可能导致随机性略有不同,但通过保留调试对比功能,用户可以轻松验证模型行为的正确性。
- 混合精度优化:针对 Gemma 4 的架构特点,优化了 FP8 与 BF16/FP16 的混合使用策略,特别是在嵌入层和注意力机制之间。
应用场景
- 多模态内容理解:上传一段视频,让 Gemma 4 31B 总结剧情、分析镜头语言或提取关键事件。
- 音频辅助创作:结合音频输入,构建播客摘要生成器或音乐评论助手。
- 本地高效编码助手:利用 Gemma 4 E4B 的低延迟特性,在 ComfyUI 中搭建实时代码补全或解释工作流。
- 复杂 Agent 构建:借助 KV Cache 共享和长上下文支持,构建具备长期记忆的多智能体协作系统。
使用建议
- 显存优化:对于 31B 模型,强烈建议开启 FP8 嵌入 和 KV Cache 共享 选项,以在 24GB 显存(如 RTX 4090)上流畅运行。
- 精度选择:日常使用推荐 BF16;若追求极致速度且能接受微小精度损失,可尝试 FP8 混合精度模式。
- 调试模式:若发现输出异常,可尝试禁用融合 RMS Norm 或使用非 SDPA 路径进行对比排查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。