SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    视频编辑

    共 18 篇文章
    排序
    发布更新浏览点赞
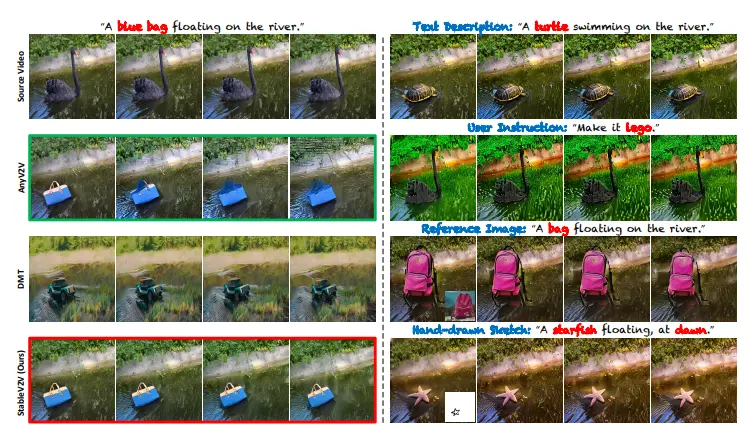
    视频编辑方法STABLEV2V:解决视频编辑中形状一致性问题

    视频编辑方法STABLEV2V:解决视频编辑中形状一致性问题

    中国科学技术大学的研究人员推出视频编辑方法STABLEV2V,旨在解决视频编辑中形状一致性问题。STABLEV2V通过一系列顺序过程来编辑视频:首先编辑第一帧视频,然后建立交付动作与用户提示之间的对齐...
    新技术# STABLEV2V# 视频编辑
    2年前
    8570
    ComfyUI-MochiEdit:针对视频生成模型Mochi的新节点,实现视频编辑和视频转视频功能

    ComfyUI-MochiEdit:针对视频生成模型Mochi的新节点,实现视频编辑和视频转视频功能

    ComfyUI-MochiEdit 是一套新的 ComfyUI 自定义节点,使用 Genmo Mochi 实现视频编辑。该工具包采用 RF-Inversion 启发的方法,首先将视频转换为噪声,然后使...
    插件# ComfyUI-MochiEdit# Mochi# 视频编辑
    2年前
    7190
    视频编辑方法I2VEdit:利用了图生视频模型,通过用户编辑视频的第一帧来引导整个视频的生成

    视频编辑方法I2VEdit:利用了图生视频模型,通过用户编辑视频的第一帧来引导整个视频的生成

    南洋理工大学、商汤科技和上海人工智能实验室的研究人员推出视频编辑方法I2VEdit,它利用了图像到视频的扩散模型,通过用户编辑视频的第一帧来引导整个视频的生成。这种方法的创新之处在于,它能够根据用户对...
    百科# I2VEdit# 视频编辑
    2年前
    1,2900
    新型视频编辑技术ReVideo:在视频中对特定区域进行精确的内容和运动控制编辑

    新型视频编辑技术ReVideo:在视频中对特定区域进行精确的内容和运动控制编辑

    北京大学深圳研究生院 、ARC实验室,腾讯 PCG和东京大学的研究人员推出新型视频编辑技术ReVideo,ReVideo的核心能力是在视频中对特定区域进行精确的内容和运动控制编辑。这意味着用户可以随心...
    新技术# ReVideo# 视频编辑
    2年前
    1,0510
    视频编辑框架AnyV2V:根据文本提示、主题或风格等不同的输入来编辑视频

    视频编辑框架AnyV2V:根据文本提示、主题或风格等不同的输入来编辑视频

    来自滑铁卢大学、Vector研究所和Harmony.AI的研究团队推出新型视频编辑框架AnyV2V,它能够让用户根据文本提示、主题或风格等不同的输入来编辑视频。 项目主页 GitHub Demo 想象...
    新技术# AnyV2V# 视频编辑
    3年前
    1,0440
    小鹏科技推出通用视频编辑框架AiAS:将任何物体无缝插入到动态视频

    小鹏科技推出通用视频编辑框架AiAS:将任何物体无缝插入到动态视频

    小鹏科技推出通用框架“Anything in Any Scene(AiAS)”,用于创建逼真视频模拟的方法,可以将任何物体无缝插入到现有的动态视频中。这种方法特别强调物理真实性,包括几何真实性、光照真...
    新技术# AiAS# 小鹏科技# 视频编辑
    3年前
    7050
    没有了

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    VideoFX

    VideoFX

    VideoFX是谷歌AI实验室的一个实验性AI视频生成产品,由 Veo 2.0模型提供支持,目前还处于抢先体验阶段,Veo 2 是一款极其高质量的视频生成模型,能够在广泛的题材和风格中创建逼真的视频内容。
    Adobe Firefly Video

    Adobe Firefly Video

    由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
    知乎直答

    知乎直答

    知乎于2024年6月推出了其全新的AI产品——“知乎直答”。这标志着知乎在AI搜索领域的功能正式产品化,并拥有了自己的独立域名和服务入口。“知乎直答”利用知乎平台丰富的真实问答数据,通过AI技术为用户提供两种答案生成方式:“简略”和“深入”,以满足不同用户的需求。此外,该产品还支持“找内容”和“找人”功能,旨在进一步缩短用户与优质回答之间的距离,提升社区创作者及其内容的可见度和流通效果。
    Alpha3D

    Alpha3D

    Alpha3D 是一款尖端工具,旨在帮助用户轻松地将文本和 2D 图像转换为完全实现的 3D 模型。这款由生成式 AI 驱动的平台对于参与创建增强现实 (AR) 内容的人来说是天赐之物,因为它简化了传统上昂贵且复杂的 3D 模型创建过程。无需深入的 3D 建模专业知识或高级设计技能,Alpha3D 使数字资产的创建大众化,使其可供从专业人士到业余爱好者等广泛受众使用。
    朱雀大模型检测

    朱雀大模型检测

    腾讯朱雀 AI 检测是于 2025 年 1 月 17 日推出的一款 AI 生成内容检测工具,主要用于帮助用户识别 AI 生成的文本和图像内容。每位用户每天最多可检测20次文本和20次图片。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      VideoFX

      VideoFX

      VideoFX是谷歌AI实验室的一个实验性AI视频生成产品,由 Veo 2.0模型提供支持,目前还处于抢先体验阶段,Veo 2 是一款极其高质量的视频生成模型,能够在广泛的题材和风格中创建逼真的视频内容。
      Adobe Firefly Video

      Adobe Firefly Video

      由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
      知乎直答

      知乎直答

      知乎于2024年6月推出了其全新的AI产品——“知乎直答”。这标志着知乎在AI搜索领域的功能正式产品化,并拥有了自己的独立域名和服务入口。“知乎直答”利用知乎平台丰富的真实问答数据,通过AI技术为用户提供两种答案生成方式:“简略”和“深入”,以满足不同用户的需求。此外,该产品还支持“找内容”和“找人”功能,旨在进一步缩短用户与优质回答之间的距离,提升社区创作者及其内容的可见度和流通效果。
      Alpha3D

      Alpha3D

      Alpha3D 是一款尖端工具,旨在帮助用户轻松地将文本和 2D 图像转换为完全实现的 3D 模型。这款由生成式 AI 驱动的平台对于参与创建增强现实 (AR) 内容的人来说是天赐之物,因为它简化了传统上昂贵且复杂的 3D 模型创建过程。无需深入的 3D 建模专业知识或高级设计技能,Alpha3D 使数字资产的创建大众化,使其可供从专业人士到业余爱好者等广泛受众使用。
      朱雀大模型检测

      朱雀大模型检测

      腾讯朱雀 AI 检测是于 2025 年 1 月 17 日推出的一款 AI 生成内容检测工具,主要用于帮助用户识别 AI 生成的文本和图像内容。每位用户每天最多可检测20次文本和20次图片。
      查看完整榜单