PromptForge
PromptForge是一款本地优先的提示词质量分析与优化开源项目,PyPI 包名为 tuneprompt。它可以从七个维度对提示词进行质量打分,自动改写低质量指令,全程保留原始意图,支持 Python API、命令行 CLI 以及 Gradio 网页界面本地运行。
Reason Machines 开源 Aspen,一款面向 AI 智能体流量的自托管 Git 服务器,采用 Apache 2.0 许可,是 OpenAI Pando 架构的独立开源实现。传统 Git 服务按仓库排队处理推送,在大量 Agent 高频提交场景下极易阻塞;Aspen 改为按分支做写入隔离,解决大规模智能体并发提交的性能瓶颈。
 Aspen
Reason Machines 近期发布了 Aspen,这是一个专为 AI 智能体并发推送流量设计的开源 Git 服务器。该框架独立实现了 OpenAI 为 Pando 描述的架构理念,旨在解决传统 Git 服务器在面对数百个智能体同时推送和 CI 频繁获取时出现的性能瓶颈。Aspen 采用 Apache 2.0 许可,目前作为研究预览版(pre-alpha)提供。
在典型的 AI 智能体工作流中,智能体可能每隔几分钟就会执行一次代码推送,而 CI/CD 系统会在每次推送后触发获取(fetch)操作。传统 Git 服务器(如 Gitea、GitLab 等)通常采用按仓库级别的锁机制,将针对同一仓库的所有推送请求排队处理。此外,服务器需要为每次获取请求重新构建数据包(packfile)。这导致服务器的工作负载随客户端数量的增加而线性增长,而非随新代码量的增加而增长,最终形成性能墙。
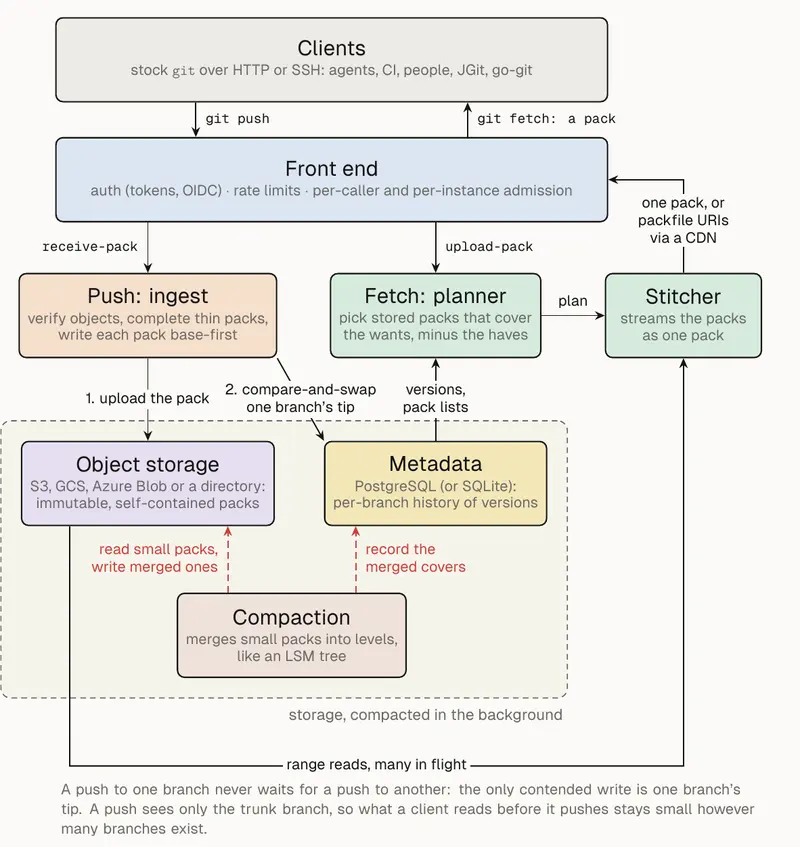
Aspen 放弃了传统 Git 服务器保留的两个主要设计主张,转而采用以下三种机制来优化高并发场景:
Aspen 将每个分支视为 PostgreSQL 数据库行中的一个版本链。推送操作首先上传其数据包,然后通过一次原子性的“比较并交换”(CAS)操作来移动分支指针。针对不同分支的推送请求永远不会相互阻塞等待。如果两个推送请求在同一分支上发生竞争,胜者更新分支,失败者将收到 Git 标准的“需要先获取(fetch first)”错误。其代价是,不同客户端在不同时刻读取到的分支状态可能存在短暂的不一致。
Aspen 在接收推送时从不解包(unpack)。它仅检查数据包的完整性,补齐缺失的基础对象,并按原样将其存储在 S3 兼容的对象存储中。当客户端执行获取操作时,Aspen 会流式传输客户端缺失的已存储数据包,而无需在服务器端重新压缩任何内容。此外,系统可通过签名 URL 直接由 CDN 提供数据包服务,进一步卸载服务器压力。
在推送协商阶段,客户端仅能看到主干(trunk)分支,这使得即使在存在数百万个分支的情况下,协商负载依然保持极低。在后台,Aspen 采用类似日志结构合并树(LSM Tree)的机制,一次性合并 16 个数据包进行分级压缩。对于深度落后于主分支的客户端,系统只需发送几十个合并后的数据包,而非数千个零散包。对于深度为 1 的 CI 获取请求,系统只需构建一次尖端数据包即可服务于所有并发作业。
以下性能数据均为官方自报,测试环境为一台 8 核服务器、S3 Standard 存储以及 4 核 PostgreSQL 数据库。测试目标为 git.git 仓库的副本(约 4,500 个文件和 75,000 次提交)。
git upload-pack 字节的 1.029 倍。main 分支时,由于 CAS 竞争机制,实际成功写入速率约为每秒 4 次。(注:Cursor 团队在其 monorepo 复制集群上报告,使用 S3 Standard 时 Origin 可达每秒 120 次推送,使用 S3 Express One Zone 时超过 300 次/s。Aspen 官方强调其提供的数字仅为指示性参考,非绝对性能承诺。)
Aspen 由 Rust 编写,支持从源码构建,并提供了从本地开发到云原生生产的多种部署路径。客户端无需任何修改,标准的 git 命令通过 HTTPS 或 SSH 即可正常工作。
1. 本地开发环境(aspen dev)
适用于快速验证和本地调试,使用 SQLite 作为元数据存储,本地文件系统作为对象存储。
# 克隆仓库并进入目录
git clone https://github.com/reasonmachines/aspen.git
cd aspen

# 运行开发模式(自动处理 SQLite 和本地目录初始化)
cargo run --bin aspen -- dev
2. 单主机 Docker Compose 部署
适用于团队内部测试或小型生产环境,提供 PostgreSQL 和 MinIO(S3 兼容对象存储)的完整容器化编排。
# 确保系统已安装 Docker 和 Docker Compose
cd aspen
docker compose up -d
启动后,可通过配置的端口访问 Git 服务,元数据持久化于 PostgreSQL 容器,数据包存储于 MinIO 容器。
3. 云原生 Kubernetes 部署 (Helm)
适用于需要高可用性和弹性伸缩的生产环境。
# 添加 Helm 仓库(假设官方已发布 chart)
helm repo add aspen https://charts.reasonmachines.com
helm repo update

# 安装 Aspen,需提前配置好集群内的 PostgreSQL 和 S3 存储凭据
helm install aspen-release aspen/aspen \
  --set postgresql.host=<your-postgres-host> \
  --set s3.endpoint=<your-s3-endpoint> \
  --set s3.accessKey=<your-access-key> \
  --set s3.secretKey=<your-secret-key>
4. 基础设施即代码部署 (Terraform)
Aspen 提供了覆盖主流云提供商的 Terraform 模块,支持在 AWS、Google Cloud、Azure 和 Hetzner 上一键部署完整的运行环境(包括计算实例、数据库和对象存储)。
# 在 main.tf 中引用模块示例
module "aspen" {
  source  = "reasonmachines/aspen/aws"
  version = "0.1.0"

  # 配置具体的云提供商参数...
}
5. 镜像模式(零迁移试用)
Aspen 支持镜像模式,可前置现有的 GitHub 或 GitLab 实例。智能体将推送发送至 Aspen,Aspen 负责处理高并发写入,并在后台异步将变更同步至上游 Git 服务器。这使得团队可以在不迁移现有代码库的前提下评估 Aspen 的性能。
尽管 Aspen 在特定并发场景下展现了显著的性能优势,但作为 pre-alpha 阶段的研究预览版,其在工程成熟度上存在以下明确限制:
main)推送时,竞争失败率会显著上升,实际吞吐量会大幅下降(如测试中的 4 次/秒)。该架构更适用于智能体在各自独立分支上并行开发的场景。