SoL-Pi
SoL-Pi 是英伟达 NVlabs 推出的 Pi Coding Agent 独立扩展插件,核心目标是**降低编码智能体的 Token 消耗,减少无效推理与重复工作,同时不降低任务产出质量**。它依托规模化自动研究循环,封装了四项可复用的效率优化机制,直接部署在原版 Pi 之上,不需要改动 Pi 源码,所有机制默认关闭,按需开启。
TokenGate 是长上下文预填充方向一个很有竞争力的可学习剪枝方案,区别于传统启发式 KV 过滤;靠 MoE 式可微 TopK 解决训练难题,不仅在标准注意力上收益巨大,还打通了 Qwen3 混合架构里 DeltaNet 层的剪枝能力。
 TokenGate
斯坦福大学与加州大学伯克利分校的研究人员联合发布了 TokenGate,这是一个专为大语言模型(LLM)长上下文预填充阶段设计的即插即用加速模块。该模块通过引入学习化的 Token 剪枝机制,使模型能够“略读”输入内容,仅对高价值 Token 进行完整处理。
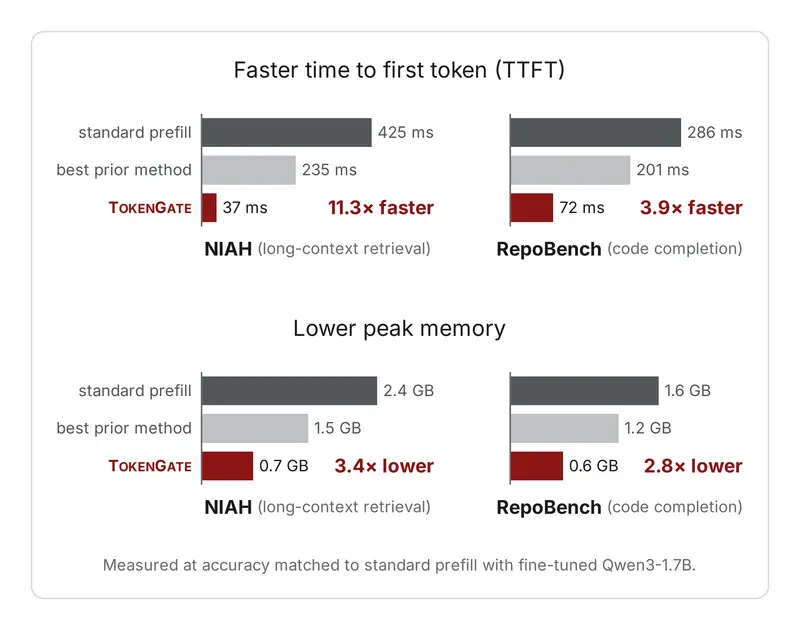
在保持模型准确性无损的前提下,TokenGate 实现了 1.4 倍至 11.3 倍的首 Token 时间(TTFT)加速,并将峰值预填充内存降低了 1.5 倍至 3.4 倍。相关代码与模型检查点已在 GitHub 上以 Apache-2.0 协议开源。
传统的免训练剪枝方法在剪枝率较高时容易导致准确性下降,而修改模型架构通常需要从头预训练。TokenGate 巧妙地通过添加一个小型 MLP 门和 LoRA(秩 r=16)模块,在现有预训练 LLM(如 Qwen3-1.7B 或 Qwen3.5-2B)中实现了可训练的 Token 剪枝。其前向传递分为三个阶段:
为了解决 Top-K 选择不可微从而阻碍端到端训练的问题,TokenGate 借鉴了混合专家(MoE)路由器的技巧。它将保留 Token 的分数作为门控注意力 logits 的偏置,从而为梯度提供了一条返回评分器的路径。结合可学习的每头增益和温度参数,该机制能够使用标准的下一 Token 预测损失进行端到端训练,使单一训练的门控模块能够适应不同的计算预算。
研究团队在 RepoBench-P、2WikiMultihopQA、MultiNews、BioDEX 和 Needle-in-a-Haystack (NIAH) 等 5 个任务上,对 Qwen3-1.7B 进行了全面评估,并与 FastKV、SlimInfer、DASH、GemFilter 和 FlexPrefill 等 6 个基线模型进行了对比。结果显示:
与 FastKV、SlimInfer、GemFilter 等依赖启发式规则或特定层过滤的免训练方法不同,TokenGate 的核心优势在于其“学习化”的 Token 选择机制。实验表明,即使是在 TokenGate 骨干网络上使用随机 K 选择,其得分也高于 FastKV 的启发式选择,这证明了模型骨干与门控模块在训练过程中实现了良好的协同适应。
TokenGate 提供了极高的工程友好度:
{state} 占位符标记可剪枝的文档部分,并在 generate 函数中通过 max_kept_prefill_tokens 参数设定计算预算。