
MineContext
MineContext 是一个具有上下文感知能力的主动式 AI 伙伴。它基于屏幕截图+内容理解的方式(未来还将支持其他来源的多模态信息,包括文档、图片、视频、代码、外部应用数据),能够看到并看懂用户的数字世界上下文,然后再基于底层的上下文工程框架,主动推送洞察、日/周总结 、待办、活动记录等高质量信息,同时支持用户基于 Context 和生成的信息进行再创作。
 cpubrrr
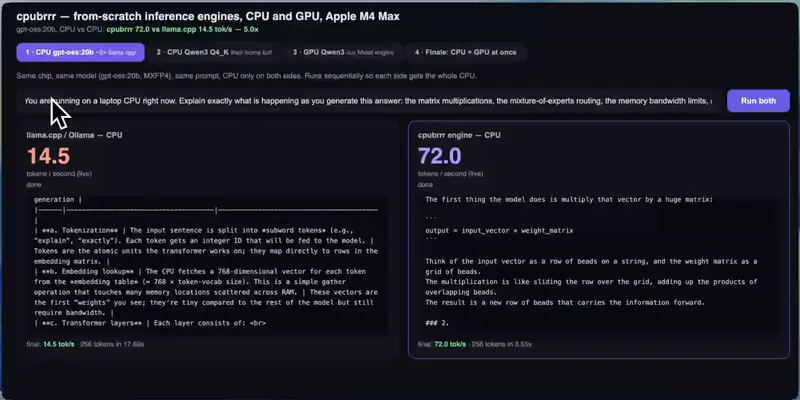
 是一个专为 Apple Silicon(特别是 M4 Max)CPU 设计的轻量级 LLM 推理运行时。它通过极致的手写优化和内存管理,实现了在完全不使用 GPU 的情况下,以显著高于 llama.cpp CPU 路径的速度运行前沿的混合专家(MoE)模型。
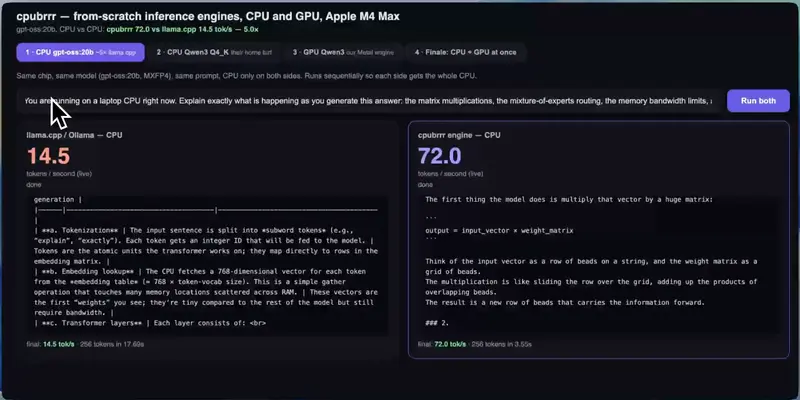
该项目最初是一个单模型实验,现已发展为一个配置驱动的引擎,支持多种架构和量化格式。其核心突破在于证明了通过精细的底层优化,CPU 也能成为高效运行大型 MoE 模型的主力军。
在 Apple M4 Max CPU 上的解码吞吐量对比(多次运行平均值):
| 模型 | 量化格式 | cpubrrr (tok/s) | llama.cpp CPU (tok/s) | 提升倍数 |
|---|---|---|---|---|
| gpt-oss:20b | MXFP4 | ~77 | ~14 | ~5× |
| Qwen3-Coder-30B | Q4_K / Q6_K | ~92 | ~82 | ~1.1–1.2× |
注:llama.cpp 的 CPU 模式通过 Ollama 服务器日志确认为仅 CPU 运行。所有输出均经过正确性验证。
MoE 模型的令牌生成主要受限于内存带宽而非计算能力。cpubrrr 通过以下技术将内存带宽利用率推向极限:
sdot 和 tbl 指令在整数硬件上直接进行精确的 4 位算术运算。llama.cpp ARM 源码中发现并优化的整数累加算法,进一步提升精度与速度的平衡。mmap 权重加载,减少不必要的内存拷贝和开销。cpubrrr 是一个配置驱动的引擎,目前支持以下模型:
mmap 技术在笔记本电脑 CPU 上流畅运行。llama.cpp 源码恢复,4 位解包逻辑已逐位针对官方 gguf 库进行验证,确保数值正确性。