AI Coding Assistant Data Extraction
AI Coding Assistant Data Extraction可以把本地 AI 编码助手的聊天历史提取出来,统一转换成标准化 JSONL 文件。提取后的对话数据,可用于模型微调、个人对话分析,或是在本地数据库被清理前,备份多年的编程会话记录。
WorldTUI 是 360M 参数小模型,不靠真实操作系统,直接预测终端屏幕画面变化;在浏览器 WebGPU 本地运行,支持 vim、tmux 等工具,通过并行解码与自纠错优化长会话一致性,但复杂场景仍会出现幻觉、状态错乱。
 WorldTUI
开发者 Simon Edwardsson 近日开源了 WorldTUI,这是一个仅有 360M 参数的轻量级语言模型,经过专门微调以模拟真实的终端环境。该模型背后没有真实的 shell 或文件系统,而是通过预测每次按键后屏幕字符网格的变化来生成响应。目前,该模型已被量化至 208 MB,并可通过 WebGPU 在浏览器标签页内实现纯本地推理。
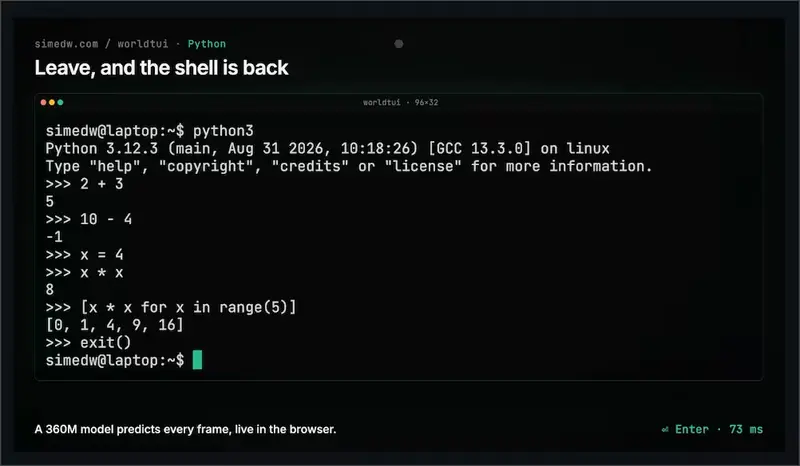
传统的 LLM 以追加 token 的方式生成文本流,这无法很好地映射终端中光标移动、清屏或局部刷新的特性。WorldTUI 将终端视为一个字符网格,模型接收屏幕快照(尺寸、内容、光标位置)和原始按键输入(如字母、回车、Escape 序列),然后输出需要重写的行及新的光标位置。
为了优化性能,模型引入了 COPY 操作。当终端滚动或清屏时,模型无需重新生成整行文本,而是直接引用前一屏幕的对应行。这使得滚动操作的 token 消耗从每行约 96 个骤降至 3 个。整个模型仅使用 333 个 token 的极小词汇表(256 个字节值 + 64 个行 token + 少量特殊操作),并通过语法约束确保每次预测都是有效的屏幕更新。
为了获得高质量的训练数据,开发者在 Docker 容器内录制了大量真实的终端会话。数据生成过程高度拟真:随机化用户名、提示符、终端尺寸,模拟人类打字(包含 1.2% 的错误率),并涵盖 vim、tmux、Python 等多种应用场景。
在训练阶段,除了常规的监督微调,WorldTUI 引入了借鉴自 DAgger 算法的“自我修正(Self-Correction)”机制。由于长会话中模型的微小错误会不断累积,训练时会故意让模型预测几步,若其生成的屏幕与真实屏幕存在偏差,系统会构造一个“修正”指令,教导模型如何在后续按键中将自己的错误屏幕引导回正确的状态。这一机制显著提升了模型在长会话中的一致性,使其在 PresetBench 测试中的得分从 24/47 提升至 38/47。
为了让模型在消费级硬件甚至浏览器中实现近实时响应,WorldTUI 进行了多项深度优化:
在能力方面,WorldTUI 展现出了令人惊讶的“记忆”与多任务处理能力。它不仅能流畅响应 bash 命令,还能处理 vim 的模式切换、tmux 的多窗格管理,甚至运行简单的 Python REPL 和贪吃蛇游戏。它能够在不同会话中记住之前创建或修改的文件内容,展现出初步的“世界模型”一致性。
然而,它仍存在明显的局限性: