Hermes Index
10月7日,Nousresearch正式推出Hermes Index大模型评测榜单,和以往侧重单纯推理能力的评测不同,这份榜单同时考核两大维度:性能指数越高越强,单任务成本越低越划算。
Datalab 推出开源结构化文档提取基准Omni Extract Bench,用来评估模型从PDF文档按照指定JSON Schema提取结构化数据的能力,目标解决行业内厂商自建排行榜难以横向对比、不透明、存在偏向性的痛点。
 Omni Extract Bench
Datalab 推出开源结构化文档提取基准Omni Extract Bench,用来评估模型从PDF文档按照指定JSON Schema提取结构化数据的能力,目标解决行业内厂商自建排行榜难以横向对比、不透明、存在偏向性的痛点。整套基准整合4套已有数据集,合计620份文档,配套确定性评分器,每一项提取结果都可追溯打分理由。
文档场景覆盖监管申报表单,其中128份单页文档,33份超过100页的长文档,长文档页面占全部页面40%。
传统表格按位置比对,只要漏掉一行,后续所有行全部错位,分数直接归零。OmniExtractBench采用匈牙利算法实现基于内容的行配对,规避这个问题:测试案例中100行表格缺首行,旧方式得0分,该基准仍能给到99%分数。
评分器会将预测JSON与标准答案展平,做值归一化(自动兼容不同日期格式,如03/31/2024和2024-03-31视为相同),对每一个字段给出6种裁决结果:
同时增加Null规则:空字符串、None、空白值判定为遗漏,避免模型填充空值刷分;NA、-这类业务标记保留原意。基于裁决结果计算准确率、精确率、召回率,指标可审计。
Datalab在10个模型配置上完成评测:
评分器包发布在PyPI:omni-extract-bench v0.1.7,Python3.11+,仅依赖SciPy,Apache 2.0许可证;数据集托管在Hugging Face,CC BY 4.0协议。
uv pip install omni-extract-bench
oeb score --pred pred.json --gt gold.json --schema schema.json --verdicts
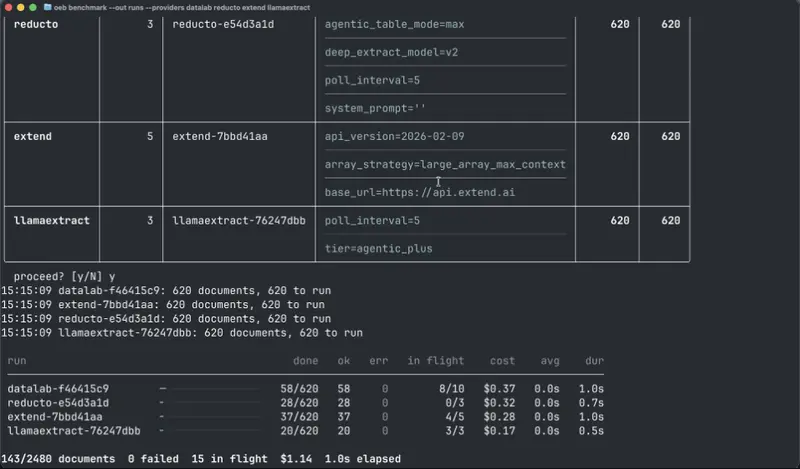
安装benchmark附加组件后,oeb benchmark可以完整重跑厂商评测,需要自行准备各大模型API密钥。