Zendesk
Zendesk 是一家软件公司,提供基于云的客户服务和销售平台,帮助企业管理支持请求和客户沟通。其通过订阅模式的层级定价计划赚钱,产品包括帮助台、工单系统和销售软件。Zendesk 的平台利用 AI、自动化和人工专长来简化客户和员工支持,目标是提高效率和客户体验。
Google DeepMind 推出 Dream-RSI,针对 AI 递归自我改进(RSI)探索循环里大量重复、浪费的代理调用问题提出新思路。传统探索方案会在大量失败路径上反复消耗 token 与调用资源,Dream-RSI 的核心思路,是让智能体在历史运行记录里 “做梦推演”,复用已经跑完的搜索结果,不用重复执行昂贵的在线调用。
 Dream-RSI
谷歌研究人员提出了一种名为 Dream-RSI(Dream-based Recursive Self-Improvement)的新框架,解决 AI 代理在递归自我改进过程中因重复探索失败路径而导致的巨大计算浪费。通过构建“历史发现树”并进行离线重放模拟,Dream-RSI 能够在不重新运行昂贵代理的情况下优化搜索策略,在关键基准测试中将发现代理的调用次数减少了多达 162 倍。
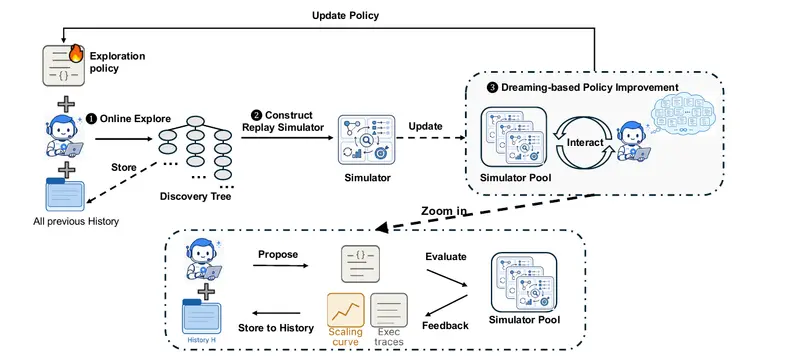
传统的递归自我改进(RSI)系统往往依赖固定的探索策略,导致代理在数千个循环中不断重复已经付费获得但被判定为失败的反馈。Dream-RSI 的核心创新在于将过去的探索历史结构化为可重用的数据资产:
研究员比喻:“历史是做梦的世界。代理已经构建的发现树是它所到达搜索空间的精确模拟器。”
在算法发现、GPU 内核工程和数学优化等多个领域的测试中,Dream-RSI 展现了极高的效率:
| 任务/基准 | 对比基线 | 效果提升 |
|---|---|---|
| Lasso 发现 | SimpleTES (gpt-oss-120b) | 代理调用减少 162 倍 (51,200 -> ~317) |
| Lasso 发现 | 递归固定探索 (Gemini-3.1-Pro) | 调用从 550 降至 317,运行时间减少 ~18% |
| GPU 内核 (VGG16) | 传统方法 | 生成次数减少 2.43 倍 |
| GPU 内核 (LayerNorm) | 传统方法 | 生成次数减少 1.79 倍 |
| ConvDiv 性能 | 同等预算下 | 性能提升 2.09 倍 |
注:SimpleTES 是现有的先进发现系统,Dream-RSI 在其基础上通过策略优化实现了数量级的成本节约。
这项研究发布在 Anthropic 联合创始人 Dario Amodei 呼吁“放慢 AI 前沿步伐”几天后。Amodei 曾担忧 RSI 可能导致 AI 失控,但 Google 的这项实验展示了 RSI 更狭隘、更务实的一面: