11ai
11ai 是一个基于对话 AI 构建的实验性个人助手,专注于通过语音实现高效任务管理与工作流自动化。它不仅是一个语音助手,更是一个能真正帮你“做事”的智能代理。
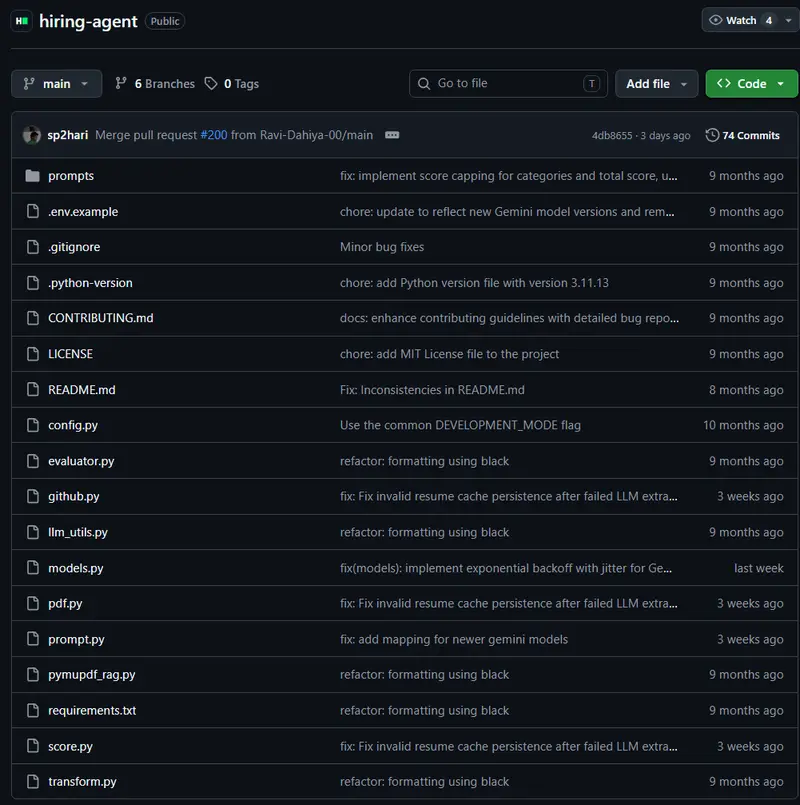
Hiring Agent 是一个开源的自动化评估工具,它通过将 PDF 简历解析为结构化数据,并结合 GitHub 仓库信号进行深度丰富,最终生成一份客观、可解释且注重公平性的评分报告。
 Hiring Agent
在传统的招聘流程中,简历筛选往往充满主观性,且难以验证候选人的实际工程能力。Hiring Agent 是一个开源的自动化评估工具,它通过将 PDF 简历解析为结构化数据,并结合 GitHub 仓库信号进行深度丰富,最终生成一份客观、可解释且注重公平性的评分报告。该工具支持完全本地化运行(通过 Ollama),确保候选人数据的隐私安全。
Hiring Agent 的处理流程分为五个关键步骤,旨在将非结构化的简历转化为可量化的工程能力指标:
PyMuPDF 将简历 PDF 转换为类 Markdown 格式,保留标题、表格和基本格式,为后续的结构化提取奠定基础。JSON Resume 格式。这种分段处理提高了提取的准确性和容错率。evaluator.py 模块运行严格的评分逻辑,内置了公平性约束以减少偏见。评分维度包括:llm_utils.py 统一不同 LLM 提供者的接口,易于扩展和维护。git clone https://github.com/interviewstreet/hiring-agent
cd hiring-agent
python -m venv .venv
source .venv/bin/activate # Linux/macOS
pip install -r requirements.txt
ollama pull gemma3:4b # 或根据显存选择 1b/12b
.env 文件中配置。cp .env.example .env
# 编辑 .env,设置 LLM_PROVIDER, DEFAULT_MODEL 等
python score.py /path/to/candidate_resume.pdf
Hiring Agent 不仅是一个简历解析器,更是一个连接“纸面经历”与“实际代码”的桥梁。它让招聘决策建立在可验证的工程信号之上,为构建高效、公平的技术团队提供了有力的工具支持。