TinyFish Bigset

5个月前发布 187 00

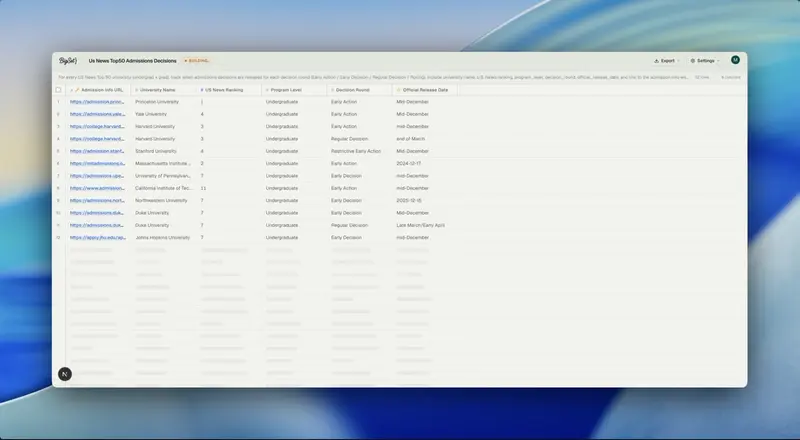
TinyFish 正式开源了多智能体系统 Bigset,它只需一句通俗的自然语言描述,即可自动推断数据结构,派遣自主智能体从真实网络中提取、验证并去重数据,最终生成可导出的 CSV 或 XLSX 表格。更令人兴奋的是,Bigset 支持定时自我刷新,让数据集始终保持最新状态,无需人工干预。
所在地:
美国
收录时间:
2026-06-04
TinyFish BigsetTinyFish Bigset

在数据驱动决策的时代,获取实时、干净且结构化的网络数据往往需要复杂的爬虫开发和漫长的维护周期。TinyFish 正式开源了 Bigset,一个多智能体系统。它只需一句通俗的自然语言描述,即可自动推断数据结构,派遣自主智能体从真实网络中提取、验证并去重数据,最终生成可导出的 CSV 或 XLSX 表格。更令人兴奋的是,Bigset 支持定时自我刷新,让数据集始终保持最新状态,无需人工干预。
TinyFish Bigset

核心亮点:自动化、可信、实时

1. 双角色多智能体协作

  • 编排智能体 (Orchestrator):负责广度优先发现,识别数据集应包含的行及来源位置,派发任务但无写入权限,确保流程可控。
  • 子智能体 (Sub-Agent):在严格预算(6 次工具调用)下研究单个实体,通过 TinyFish Search/Fetch 提取真实数据,插入经过验证的行,并记录来源 URL 及发现过程。

2. 严格的数据质量控制

  • 拒绝幻觉:子智能体被指示永不编造数值,无法确认时留空字段。
  • 自动去重:基于主键自动拒绝重复条目,确保数据唯一性。
  • 来源可溯:每一行数据均附带来源 URL 及完整的发现日志,便于审计与验证。

3. 自我刷新与定时更新

  • 持续保鲜:支持设置从 30 分钟到每周 的刷新频率,智能体按计划重新运行,自动捕捉网络变化。
  • 零维护:一旦设定,无需任何人触碰脚本或代码,数据集即可自动演进。

4. 灵活配置与开源自由

  • 多模型支持:默认使用 Claude Sonnet 4.6 进行结构推理,Qwen3.7-max 处理智能体角色,全部通过 OpenRouter 路由,且每个角色均可自定义配置。
  • AGPL-3.0 许可:完全开源,支持 Docker 自托管,拥有完整的流程所有权,无席位费限制,无领域限制。
TinyFish Bigset

工作流程:从指令到表格

  1. 输入指令:用户用自然语言描述所需数据(如“列出全球前 50 家 AI 初创公司及其最新融资额”)。
  2. 结构推断:编排智能体分析意图,确定数据 schema 及潜在来源。
  3. 任务派发:编排智能体识别目标实体,派发子智能体进行逐个研究。
  4. 提取与验证:子智能体访问真实网页,提取数据,验证真实性,记录来源。
  5. 组装与去重:系统将验证后的数据组装成表,自动去除重复项。
  6. 输出与刷新:生成 CSV/XLSX 文件,并根据设定计划定期重新执行上述步骤。

性能与限制

  • 速度:构建一个数据集通常需 2-5 分钟。
  • 适用场景:在拥有公开网络数据的主题上表现最佳。
  • 免费额度:每月覆盖 2,500 次行操作,附带 9 个精选公共数据集供免账户浏览。
  • 状态:目前处于实验阶段,欢迎社区反馈与贡献。

关于 TinyFish

  • 背景:总部位于帕洛阿尔托,由 ICONIQ 领投完成 4700 万美元 A 轮融资。
  • 客户:服务于 Google、DoorDash、亚马逊等企业巨头。
  • 规模:已处理超过 4000 万次 智能体操作。
  • 愿景:Bigset 是其企业级智能体产品背后的网络基础设施(TinyFish Search/Fetch)的开源化身,旨在提供透明、可控且无锁定风险的数据采集方案。

相关导航