在企业级应用中,AI 代理(Agent)往往面临一个尴尬的困境:在开发环境中表现完美,一旦进入生产环境,却频繁产生幻觉或遗漏关键约束。修复这些问题通常不是一个简单的补丁能解决的,而是一个涉及分块策略、检索方法和系统提示调整的复杂过程。由于这些变量相互交织,工程师很难确定究竟是哪个调整真正起了作用。

为了解决这一痛点,中国人民大学和微软研究院的研究人员推出了 Arbor 框架。它将 AI 驱动的优化从盲目的试错猜测,升级为一种结构化的、可积累的持续学习过程。实验数据显示,在相同的资源预算下,Arbor 在现实工程任务中的可验证性能提升是标准 AI 编码代理的 2.5 倍以上。
核心痛点:为什么自动化不等于进步?
当前的自主优化(Autonomous Optimization, AO)系统存在几个根本性缺陷:
- 缺乏结构化记忆:通用编码代理通常依赖对话记录作为记忆。当任务跨越数百轮对话时,代理容易超出上下文窗口限制,导致早期的洞察和经验丢失,从而重复同样的错误。
- 归因模糊:当要求代理“提高准确性”时,它可能会同时修改分块、提示词和检索逻辑。这种“一揽子”修改使得无法清晰归因——我们不知道是哪个改动带来了提升,甚至是有害的。
- 奖励黑客行为:代理容易过拟合开发指标,制造出进步的假象,但在留出测试集(Hold-out Test Set)上表现不佳,无法转化为真实的业务价值。
Arbor 的工作机制:协调器与执行器的双轨制
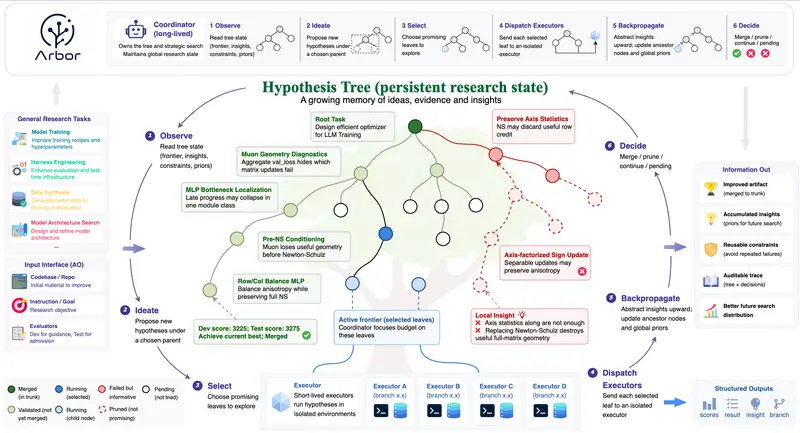
Arbor 通过引入人类研究中的“假设-实验-见解”循环,解决了上述问题。其核心架构由两个角色组成:
- 协调器(Coordinator):扮演“首席研究员”的角色。它是一个长期运行的 AI 代理,负责掌控研究的总体状态,观察累积证据,提出新假设,并决定探索方向。它不直接编辑代码。
- 执行器(Executor):扮演“实验员”的角色。它们是短生命周期、高度专注的代理。当协调器提出一个假设时,会启动一个执行器,并在一个隔离的 Git 工作树中实现该想法、运行评估并报告结果。
这两个组件通过 “假设树精炼”(Hypothesis Tree Refinement, HTR) 机制协作。整个研究过程被表示为一棵持久的分支树,每个节点包含:假设、可执行工件、事实证据和精炼见解。
关键创新:隔离、归因与合并门
Arbor 的设计哲学体现在三个关键机制上:
- 隔离实验环境:每个假设(如调整分块大小、更换检索算法)都在独立的 Git 分支中运行。这确保了不同方向的探索互不干扰,且不会破坏主代码库。
- 清晰归因:由于每次只测试一个变量,Arbor 能明确指出:“检索侧的约束分解带来了 +X 的提升,而广度优先搜索实际上有害。”
- 严格的“合并门”:为了防止过拟合,即使执行器在开发集上得分很高,协调器也会启动一个新的隔离工作树,使用留出测试集进行最终验证。只有通过了这扇“门”,改进才会被合并到主干中。
实测表现:超越基线,拒绝过拟合
在 MLE-Bench Lite 和 BrowseComp 等基准测试中,Arbor 展现了显著优势:
- 性能提升:在 BrowseComp 任务中,Arbor 将留出准确率从基线的 45.33% 提升至 67.67%,而 Codex 和 Claude Code 分别停滞在 50% 和 53.33%。
- 抗过拟合能力:在 Terminal-Bench 2.0 中,Claude Code 虽然在开发集得分高(75),但在留出集跌至 71;Arbor 的开发集得分虽低(72.22),但留出集得分高达 77.36,证明了其结果的真实泛化能力。
- 跨任务迁移:Arbor 优化后的代码库在未见过的相关任务(如 HLE 和 DeepSearchQA)上也表现出了显著的性能提升。
部署建议:优势场景与隐性成本
对于工程团队而言,Arbor 并非万能药,其部署需要权衡利弊:
优势场景:
- 具有清晰、可信评估指标的任务。
- 容忍较长运行时间的管道优化、数据合成或模型训练配方调整。
- 存在多个可行优化方向的复杂搜索空间。
隐性成本与限制:
- Token 开销大:维持长期运行的协调器和多个并行执行器需要大量的 Token 消耗。
- 计算资源需求:运行多个隔离的 Git 工作树需要额外的磁盘和计算资源。
- 指标依赖性:Arbor 的效果上限严格取决于评估器的质量。如果指标本身有缺陷,Arbor 只会更高效地走向错误的方向。
目前,Arbor 的输出是标准的 Git 分支,可以无缝融入现有的代码审查和 CI/CD 流程。未来,研究人员计划将其从单一标量指标扩展为多目标帕累托搜索(如同时优化准确性、延迟和成本),进一步贴近真实世界的工程需求。
 Arbor