Rust LLM from Scratch
Rust LLM from Scratch是一个完全使用纯 Rust 实现的、没有外部机器学习框架的大语言模型。从头构建,仅使用 ndarray 进行矩阵运算。
 FlagOS
在 AI 芯片种类繁多、软件栈各自为战的当下,如何实现“一次开发,跨芯片部署”成为行业难题。北京智源研究院联合国内外众多科研机构、芯片厂商及软件组织,正式发起成立 FlagOS 开源社区,致力于构建连接“模型-系统-芯片”各层的统一开源系统软件栈。
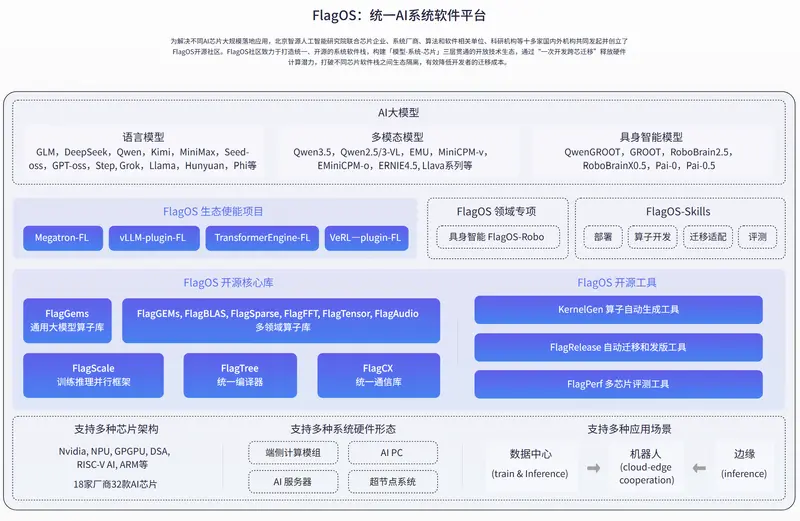
随着 FlagOS 的发布,面壁智能的最新模型 MiniCPM5-1B 已在极短时间内适配了包括 Nvidia、华为昇腾、海光、摩尔线程等在内的 9 种主流 AI 芯片,标志着异构算力生态互通迈出了关键一步。
FlagOS 旨在解决 AI 硬件生态碎片化问题,通过提供以下核心组件,打造开放的技术生态:
核心价值:
得益于 FlagOS 的统一软件栈,MiniCPM5-1B 已迅速完成多芯片适配,并通过 FlagRelease 平台发布。FlagRelease 是一个用于在多架构 AI 芯片上自动迁移、适配和部署大模型的一站式平台。
| 厂商 | ModelScope 模型名称 | Huggingface 模型名称 |
|---|---|---|
| Nvidia | MiniCPM5-1B-nvidia-FlagOS | MiniCPM5-1B-nvidia-FlagOS |
| Hygon (海光) | MiniCPM5-1B-hygon-FlagOS | MiniCPM5-1B-hygon-FlagOS |
| Metax (沐曦) | MiniCPM5-1B-metax-FlagOS | MiniCPM5-1B-metax-FlagOS |
| Iluvatar (天数智芯) | MiniCPM5-1B-iluvatar-FlagOS | MiniCPM5-1B-iluvatar-FlagOS |
| Zhenwu (真吾) | MiniCPM5-1B-zhenwu-FlagOS | MiniCPM5-1B-zhenwu-FlagOS |
| Mthreads (摩尔线程) | MiniCPM5-1B-mthreads-FlagOS | MiniCPM5-1B-mthreads-FlagOS |
| Kunlunxin (昆仑芯) | MiniCPM5-1B-kunlunxin-FlagOS | MiniCPM5-1B-kunlunxin-FlagOS |
| Ascend (华为昇腾) | MiniCPM5-1B-ascend-FlagOS | MiniCPM5-1B-ascend-FlagOS |
| ARM-v9 | MiniCPM5-1B-Armv9-FlagOS | MiniCPM5-1B-Armv9-FlagOS |
FlagRelease 提供了预装所有必需软件包的容器镜像,用户无需自行配置环境,即可快速启动服务。
对于希望深度定制或研究底层优化的开发者,可以手动安装 FlagOS 组件。
1. 前置依赖
2. 安装 FlagGems 算子库
FlagGems 是 FlagOS 的核心加速库,兼容 Triton。
pip install flag-gems==4.2.1rc0
pip install triton==3.5.1
3. 启用加速并启动 vLLM 服务
在 vLLM 源代码中导入并启用 flagGems:
import flag_gems
flag_gems.enable(record=True, once=True, path="/root/gems.txt")
启动服务命令示例:
vllm serve ${model_path} \
  --trust-remote-code \
  --dtype bfloat16 \
  --enforce-eager \
  --port ${Port} \
  --served-model-name ${model_name} \
  --gpu-memory-utilization 0.85
vllm-plugin-FL 是基于 FlagOS 统一多芯片后端开发的 vLLM 插件,旨在扩展 vLLM 在各种硬件环境中的功能。
vllm-plugin-FL/MiniCPM5-1BMiniCPM5-1B-nvidia-FlagOS通过“立足中国、拥抱全球”的策略,FlagOS 有望打破软硬件生态壁垒,促进 AI 技术的普惠部署。对于开发者而言,这意味着更低的适配成本和更灵活的选择权;对于产业而言,这意味着更高效、更安全的 AI 基础设施底座。